Generic selectors
Exact matches only
Search in title
Search in content
Post Type Selectors

NVIDIA detalha como o NVLink 6 protege fábricas de IA contra falhas

NVIDIA detalha como o NVLink 6 protege fábricas de IA contra falhas
A NVIDIA detalhou como o NVLink 6 combina correção de erros, controle de fluxo, recuperação de software e manutenção de racks para manter fábricas de IA operando mesmo sob falhas.

Índice

Tempo de leitura: 6 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Em um data center dedicado à inteligência artificial, uma falha aparentemente pequena pode interromper milhares de operações simultâneas. É por isso que a NVIDIA publicou, em 15 de setembro de 2026, uma explicação sobre como o NVLink 6 combina recursos de hardware, rede e software para manter fábricas de IA funcionando mesmo quando surgem erros de sinal, degradação de links ou interrupções em nós do sistema.

A proposta não é apenas aumentar a largura de banda entre GPUs. Segundo a NVIDIA, a confiabilidade precisa ser construída em várias camadas, porque nenhum mecanismo isolado consegue lidar sozinho com todos os tipos de falha. A arquitetura começa corrigindo problemas diretamente no nível físico e termina preservando aplicações e processos de inferência. É essa combinação que transforma uma rede rápida em uma infraestrutura capaz de continuar operando sob pressão.

Como o NVLink 6 cria uma arquitetura resiliente para fábricas de IA

O cenário descrito pela NVIDIA envolve cargas de trabalho nas quais milhares de GPUs precisam sincronizar dados constantemente. Durante o treinamento, uma interrupção pode afetar operações coletivas entre os aceleradores. Na inferência, o impacto aparece como redução da capacidade de atendimento e aumento do tempo de resposta.

Para evitar que um único erro se transforme em uma paralisação maior, o NVLink 6 organiza sua resiliência em diferentes níveis. A camada física corrige erros de transmissão; a camada de enlace impede a perda de pacotes; o software isola falhas e recupera processos; e a camada de sistema ajuda a realizar manutenção sem interromper todo o domínio de computação.

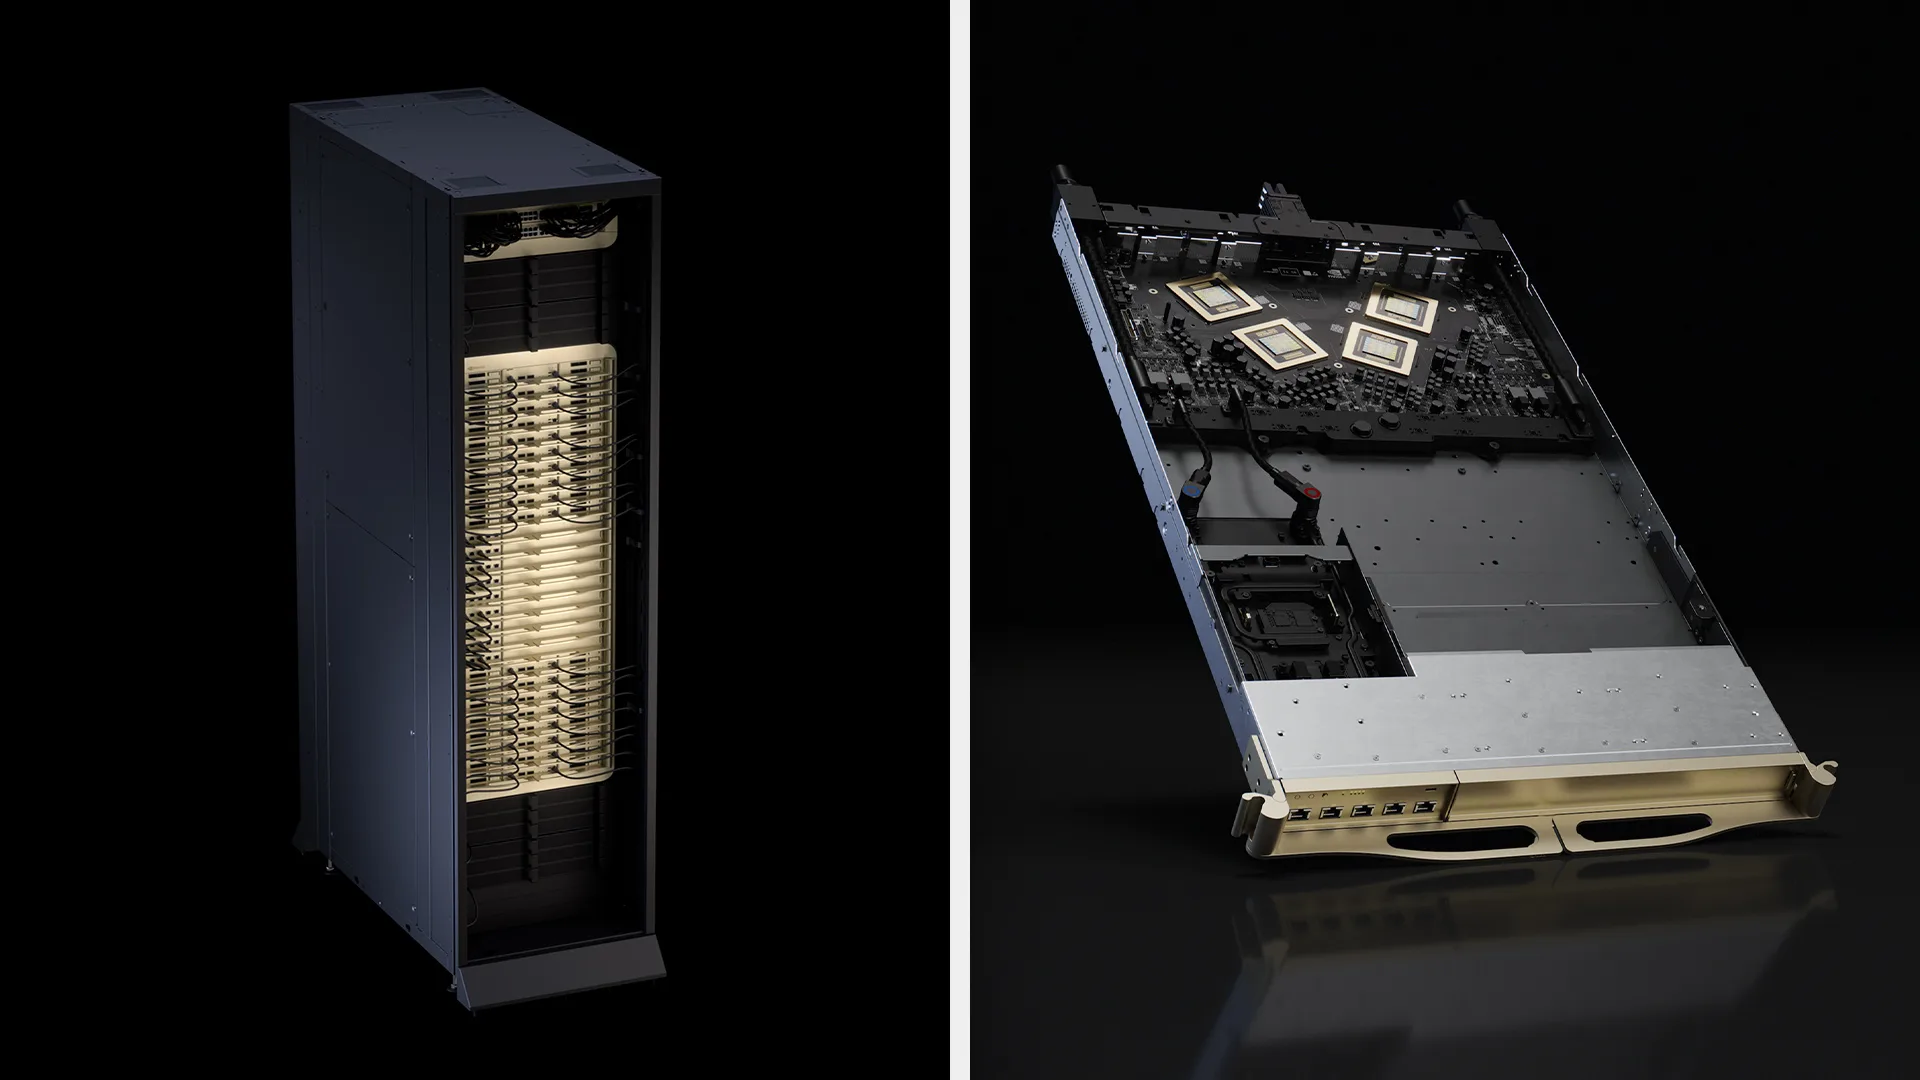
Essa abordagem se aplica ao Vera Rubin NVL72, plataforma que conecta 72 GPUs Rubin em um único domínio de expansão por meio do NVLink 6, de acordo com as informações apresentadas pela empresa. Na prática, a rede precisa agir como um sistema integrado, e não como uma coleção de componentes independentes.

NVLink 6 corrige erros no nível físico antes que eles se espalhem

Em velocidades de sinal extremamente altas, ruído elétrico e degradação do sinal podem produzir erros de bits. O NVLink 6 combina Forward Error Correction (FEC), Physical Layer Retry (PLR) e recuperação da camada física UPHY para lidar com esses problemas antes que eles alcancem camadas superiores.

O FEC adiciona códigos ao fluxo de dados para que o receptor consiga reconstruir bits corrompidos sem depender imediatamente de uma retransmissão. Quando um erro ultrapassa a capacidade de correção desse mecanismo, o PLR retransmite os dados diretamente na camada física. Assim, a recuperação não precisa esperar pela intervenção de protocolos de software mais lentos.

Em situações de degradação mais severa, a recuperação UPHY recalibra os parâmetros físicos do link. Enquanto isso acontece, os pacotes podem permanecer protegidos em um buffer de replay. A ideia é evitar que uma mudança temporária na qualidade do sinal resulte em perda de dados ou em uma interrupção ampla da comunicação.

O controle baseado em créditos evita a perda de pacotes

Na camada de enlace, o NVLink 6 utiliza credit-based flow control (CBFC). O transmissor só envia um pacote quando possui créditos que indicam a existência de espaço disponível no próximo destino. Em vez de enviar dados e reagir depois que um buffer fica cheio, o sistema verifica previamente se a transmissão pode ocorrer com segurança.

Essa diferença é importante porque transforma o controle de congestionamento em um processo preventivo. Segundo a NVIDIA, o método evita que os pacotes sejam descartados no caminho e mantém um comportamento mais previsível para cargas de trabalho sensíveis à latência.

A empresa compara essa estratégia com mecanismos reativos usados em redes Ethernet, como Priority Flow Control e Explicit Congestion Notification. Esses mecanismos podem ajudar a controlar congestionamentos, mas também estão sujeitos a problemas como bloqueio de filas, tempestades de mensagens de pausa e deadlocks. No NVLink 6, a intenção é impedir que a própria tentativa de controlar o congestionamento crie uma nova fonte de instabilidade.

Quando um link físico começa a apresentar problemas, o Link Manager também pode redistribuir o tráfego entre links de acesso e links de tronco. Dessa forma, a rede tenta compensar a degradação local sem provocar uma reação em cadeia no restante da infraestrutura.

O software isola falhas sem interromper toda a rede

Nem todos os problemas podem ser resolvidos no nível físico. Por isso, o NVLink 6 inclui mecanismos de recuperação de software que colocam links afetados em um estado de “conter e drenar”. O objetivo é isolar a área problemática, concluir o tratamento dos dados pendentes e impedir que a falha provoque pressão de retorno em todo o fabric.

O NMX Controller participa desse processo ao trabalhar com os drivers das GPUs. A arquitetura também utiliza o NMX High Availability para transferir funções de controle para uma bandeja alternativa quando o componente principal falha. De acordo com a NVIDIA, essa separação permite que o plano de dados continue encaminhando tráfego mesmo durante uma reinicialização da CPU de gerenciamento ou do sistema operacional do switch.

É uma distinção parecida com manter uma estrada aberta enquanto a central de controle é reiniciada. O gerenciamento pode ficar temporariamente indisponível, mas os veículos que já estão na estrada não precisam parar automaticamente.

Shadow Engine Recovery reduz o tempo de retorno da inferência

Uma falha grave ainda pode atingir a camada de aplicação e interromper o processo que serve um modelo de linguagem. Em uma reinicialização tradicional, seria necessário recarregar os pesos do modelo na memória HBM, recompilar kernels e recriar gráficos CUDA. Em modelos grandes, esse processo pode consumir vários minutos.

Para reduzir esse intervalo, a NVIDIA descreve o Shadow Engine Recovery, recurso do NVIDIA Dynamo que mantém uma réplica previamente inicializada do mecanismo de inferência. Esse processo secundário possui seus próprios comunicadores NCCL e NIXL, além de uma topologia de rede preparada para assumir o trabalho.

Quando o processo principal perde sua comunicação com o restante do sistema, a réplica pode retomar as operações distribuídas sem reconstruir toda a infraestrutura do zero. Em testes mencionados pela NVIDIA com GPUs B200, o tempo para restaurar a capacidade de atendimento caiu de 283 segundos, em uma reinicialização fria, para 7,3 segundos com o Shadow Engine Recovery.

A empresa também cita suporte de protótipo do NCCL ao cuda-checkpoint para criar checkpoints em múltiplos nós. A previsão informada no material é de disponibilidade geral até o fim de 2026, mas essa informação deve ser confirmada antes de uma publicação definitiva, porque prazos e status de recursos podem mudar.

A manutenção do rack também faz parte da resiliência

A proteção contra falhas não termina na recuperação de pacotes ou processos. Em uma fábrica de IA, componentes físicos precisam ser substituídos e mantidos sem necessariamente interromper todos os trabalhos ativos.

Segundo a NVIDIA, o NVLink 6 permite colocar uma bandeja de switch em estado administrativo para manutenção direcionada. A bandeja substituída permanece fora de operação até ser verificada e ativada explicitamente, evitando que um componente ainda não validado seja reinserido prematuramente no domínio.

A arquitetura também suporta racks parcialmente preenchidos. O NMX Controller pode detectar o hardware disponível e configurar as rotas correspondentes, o que facilita implantações graduais e intervenções durante ciclos de manutenção.

NVLink Fusion leva a mesma abordagem a aceleradores personalizados

A NVIDIA afirma que essa estrutura de resiliência não está limitada a sistemas compostos exclusivamente por GPUs da empresa. Com o NVLink Fusion, fabricantes de chips e grandes operadores de infraestrutura podem conectar aceleradores personalizados à rede de expansão da NVIDIA.

A proposta é permitir que esses XPUs aproveitem a mesma combinação de correção de erros, controle de fluxo, isolamento de falhas e recuperação de software. Para empresas que desenvolvem silício próprio, isso pode reduzir o esforço necessário para criar uma rede de alta velocidade com mecanismos de tolerância a falhas em escala.

Por que a resiliência é tão importante quanto a velocidade

O anúncio mostra uma mudança importante na forma de avaliar redes para inteligência artificial. Medir apenas largura de banda não revela quanto tempo uma infraestrutura perde quando um link degrada, um processo cai ou uma bandeja precisa ser substituída.

O diferencial apresentado no NVLink 6 está na combinação de respostas com diferentes tempos de recuperação: correção quase imediata no nível físico, retransmissão rápida na camada de enlace, recuperação de software em segundos e mecanismos de checkpoint para interrupções mais amplas. Cada camada tenta resolver o problema no ponto mais próximo de sua origem.

Essa estratégia não elimina a possibilidade de falhas. O que ela busca fazer é impedir que uma falha localizada se transforme em uma paralisação de todo o sistema. Para fábricas de IA, essa diferença pode determinar se uma interrupção será apenas um evento absorvido pela infraestrutura ou uma queda perceptível na capacidade de treinamento e inferência.

Fontes

RECENTES

NVIDIA usa gêmeos digitais para validar mudanças em fábricas de IA
A NVIDIA apresentou uma abordagem que combina o DSX Air, o Brev e agentes de IA para testar configurações e integrações de fábricas de IA antes da implantação física.
NVIDIA cuOpt mPDLP leva a otimização linear a mais de 100 milhões de variáveis
A NVIDIA apresentou o cuOpt mPDLP, método multi-GPU que distribui problemas de programação linear com mais de 100 milhões de variáveis e reduz a pressão sobre memória e tempo de processamento.

LEIS MAIS


CONTINUE NO PLANKSNET

NVIDIA usa gêmeos digitais para validar mudanças em fábricas de IA
8 min de leitura
A NVIDIA apresentou uma abordagem que combina o DSX Air, o Brev e agentes de IA para testar configurações e integrações de fábricas de IA antes da implantação física.
NVIDIA cuOpt mPDLP leva a otimização linear a mais de 100 milhões de variáveis
5 min de leitura
A NVIDIA apresentou o cuOpt mPDLP, método multi-GPU que distribui problemas de programação linear com mais de 100 milhões de variáveis e reduz a pressão sobre memória e tempo de processamento.

VEJA TAMBÉM

NVIDIA detalha como o NVLink 6 protege fábricas de IA contra falhas

NVIDIA detalha como o NVLink 6 protege fábricas de IA contra falhas
A NVIDIA detalhou como o NVLink 6 combina correção de erros, controle de fluxo, recuperação de software e manutenção de racks para manter fábricas de IA operando mesmo sob falhas.

Índice

Tempo de leitura: 6 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Em um data center dedicado à inteligência artificial, uma falha aparentemente pequena pode interromper milhares de operações simultâneas. É por isso que a NVIDIA publicou, em 15 de setembro de 2026, uma explicação sobre como o NVLink 6 combina recursos de hardware, rede e software para manter fábricas de IA funcionando mesmo quando surgem erros de sinal, degradação de links ou interrupções em nós do sistema.

A proposta não é apenas aumentar a largura de banda entre GPUs. Segundo a NVIDIA, a confiabilidade precisa ser construída em várias camadas, porque nenhum mecanismo isolado consegue lidar sozinho com todos os tipos de falha. A arquitetura começa corrigindo problemas diretamente no nível físico e termina preservando aplicações e processos de inferência. É essa combinação que transforma uma rede rápida em uma infraestrutura capaz de continuar operando sob pressão.

Como o NVLink 6 cria uma arquitetura resiliente para fábricas de IA

O cenário descrito pela NVIDIA envolve cargas de trabalho nas quais milhares de GPUs precisam sincronizar dados constantemente. Durante o treinamento, uma interrupção pode afetar operações coletivas entre os aceleradores. Na inferência, o impacto aparece como redução da capacidade de atendimento e aumento do tempo de resposta.

Para evitar que um único erro se transforme em uma paralisação maior, o NVLink 6 organiza sua resiliência em diferentes níveis. A camada física corrige erros de transmissão; a camada de enlace impede a perda de pacotes; o software isola falhas e recupera processos; e a camada de sistema ajuda a realizar manutenção sem interromper todo o domínio de computação.

Essa abordagem se aplica ao Vera Rubin NVL72, plataforma que conecta 72 GPUs Rubin em um único domínio de expansão por meio do NVLink 6, de acordo com as informações apresentadas pela empresa. Na prática, a rede precisa agir como um sistema integrado, e não como uma coleção de componentes independentes.

NVLink 6 corrige erros no nível físico antes que eles se espalhem

Em velocidades de sinal extremamente altas, ruído elétrico e degradação do sinal podem produzir erros de bits. O NVLink 6 combina Forward Error Correction (FEC), Physical Layer Retry (PLR) e recuperação da camada física UPHY para lidar com esses problemas antes que eles alcancem camadas superiores.

O FEC adiciona códigos ao fluxo de dados para que o receptor consiga reconstruir bits corrompidos sem depender imediatamente de uma retransmissão. Quando um erro ultrapassa a capacidade de correção desse mecanismo, o PLR retransmite os dados diretamente na camada física. Assim, a recuperação não precisa esperar pela intervenção de protocolos de software mais lentos.

Em situações de degradação mais severa, a recuperação UPHY recalibra os parâmetros físicos do link. Enquanto isso acontece, os pacotes podem permanecer protegidos em um buffer de replay. A ideia é evitar que uma mudança temporária na qualidade do sinal resulte em perda de dados ou em uma interrupção ampla da comunicação.

O controle baseado em créditos evita a perda de pacotes

Na camada de enlace, o NVLink 6 utiliza credit-based flow control (CBFC). O transmissor só envia um pacote quando possui créditos que indicam a existência de espaço disponível no próximo destino. Em vez de enviar dados e reagir depois que um buffer fica cheio, o sistema verifica previamente se a transmissão pode ocorrer com segurança.

Essa diferença é importante porque transforma o controle de congestionamento em um processo preventivo. Segundo a NVIDIA, o método evita que os pacotes sejam descartados no caminho e mantém um comportamento mais previsível para cargas de trabalho sensíveis à latência.

A empresa compara essa estratégia com mecanismos reativos usados em redes Ethernet, como Priority Flow Control e Explicit Congestion Notification. Esses mecanismos podem ajudar a controlar congestionamentos, mas também estão sujeitos a problemas como bloqueio de filas, tempestades de mensagens de pausa e deadlocks. No NVLink 6, a intenção é impedir que a própria tentativa de controlar o congestionamento crie uma nova fonte de instabilidade.

Quando um link físico começa a apresentar problemas, o Link Manager também pode redistribuir o tráfego entre links de acesso e links de tronco. Dessa forma, a rede tenta compensar a degradação local sem provocar uma reação em cadeia no restante da infraestrutura.

O software isola falhas sem interromper toda a rede

Nem todos os problemas podem ser resolvidos no nível físico. Por isso, o NVLink 6 inclui mecanismos de recuperação de software que colocam links afetados em um estado de “conter e drenar”. O objetivo é isolar a área problemática, concluir o tratamento dos dados pendentes e impedir que a falha provoque pressão de retorno em todo o fabric.

O NMX Controller participa desse processo ao trabalhar com os drivers das GPUs. A arquitetura também utiliza o NMX High Availability para transferir funções de controle para uma bandeja alternativa quando o componente principal falha. De acordo com a NVIDIA, essa separação permite que o plano de dados continue encaminhando tráfego mesmo durante uma reinicialização da CPU de gerenciamento ou do sistema operacional do switch.

É uma distinção parecida com manter uma estrada aberta enquanto a central de controle é reiniciada. O gerenciamento pode ficar temporariamente indisponível, mas os veículos que já estão na estrada não precisam parar automaticamente.

Shadow Engine Recovery reduz o tempo de retorno da inferência

Uma falha grave ainda pode atingir a camada de aplicação e interromper o processo que serve um modelo de linguagem. Em uma reinicialização tradicional, seria necessário recarregar os pesos do modelo na memória HBM, recompilar kernels e recriar gráficos CUDA. Em modelos grandes, esse processo pode consumir vários minutos.

Para reduzir esse intervalo, a NVIDIA descreve o Shadow Engine Recovery, recurso do NVIDIA Dynamo que mantém uma réplica previamente inicializada do mecanismo de inferência. Esse processo secundário possui seus próprios comunicadores NCCL e NIXL, além de uma topologia de rede preparada para assumir o trabalho.

Quando o processo principal perde sua comunicação com o restante do sistema, a réplica pode retomar as operações distribuídas sem reconstruir toda a infraestrutura do zero. Em testes mencionados pela NVIDIA com GPUs B200, o tempo para restaurar a capacidade de atendimento caiu de 283 segundos, em uma reinicialização fria, para 7,3 segundos com o Shadow Engine Recovery.

A empresa também cita suporte de protótipo do NCCL ao cuda-checkpoint para criar checkpoints em múltiplos nós. A previsão informada no material é de disponibilidade geral até o fim de 2026, mas essa informação deve ser confirmada antes de uma publicação definitiva, porque prazos e status de recursos podem mudar.

A manutenção do rack também faz parte da resiliência

A proteção contra falhas não termina na recuperação de pacotes ou processos. Em uma fábrica de IA, componentes físicos precisam ser substituídos e mantidos sem necessariamente interromper todos os trabalhos ativos.

Segundo a NVIDIA, o NVLink 6 permite colocar uma bandeja de switch em estado administrativo para manutenção direcionada. A bandeja substituída permanece fora de operação até ser verificada e ativada explicitamente, evitando que um componente ainda não validado seja reinserido prematuramente no domínio.

A arquitetura também suporta racks parcialmente preenchidos. O NMX Controller pode detectar o hardware disponível e configurar as rotas correspondentes, o que facilita implantações graduais e intervenções durante ciclos de manutenção.

NVLink Fusion leva a mesma abordagem a aceleradores personalizados

A NVIDIA afirma que essa estrutura de resiliência não está limitada a sistemas compostos exclusivamente por GPUs da empresa. Com o NVLink Fusion, fabricantes de chips e grandes operadores de infraestrutura podem conectar aceleradores personalizados à rede de expansão da NVIDIA.

A proposta é permitir que esses XPUs aproveitem a mesma combinação de correção de erros, controle de fluxo, isolamento de falhas e recuperação de software. Para empresas que desenvolvem silício próprio, isso pode reduzir o esforço necessário para criar uma rede de alta velocidade com mecanismos de tolerância a falhas em escala.

Por que a resiliência é tão importante quanto a velocidade

O anúncio mostra uma mudança importante na forma de avaliar redes para inteligência artificial. Medir apenas largura de banda não revela quanto tempo uma infraestrutura perde quando um link degrada, um processo cai ou uma bandeja precisa ser substituída.

O diferencial apresentado no NVLink 6 está na combinação de respostas com diferentes tempos de recuperação: correção quase imediata no nível físico, retransmissão rápida na camada de enlace, recuperação de software em segundos e mecanismos de checkpoint para interrupções mais amplas. Cada camada tenta resolver o problema no ponto mais próximo de sua origem.

Essa estratégia não elimina a possibilidade de falhas. O que ela busca fazer é impedir que uma falha localizada se transforme em uma paralisação de todo o sistema. Para fábricas de IA, essa diferença pode determinar se uma interrupção será apenas um evento absorvido pela infraestrutura ou uma queda perceptível na capacidade de treinamento e inferência.

Fontes

NVIDIA detalha como o NVLink 6 protege fábricas de IA contra falhas

VEJA TAMBÉM