Tempo de leitura: 6 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Em uma publicação de 29 de setembro de 2026, a NVIDIA detalhou as lições obtidas durante a construção do TensorRT Model Connect, um projeto de código aberto que reúne implementações de referência de modelos de IA em C++ sobre o NVIDIA TensorRT. Mais do que apresentar uma ferramenta, o texto discute como o desenvolvimento nativo de IA pode mudar a forma de organizar software, agentes de programação e validação.
A proposta não é simplesmente deixar agentes escreverem código em maior velocidade. O desafio é criar uma estrutura na qual muitas implementações possam ser exploradas sem transformar cada erro em um problema generalizado. É aí que entram a divisão de tarefas, o isolamento entre famílias de modelos, as mudanças reversíveis e uma validação capaz de separar candidatos promissores de software realmente confiável.
O que significa desenvolvimento nativo de IA no TensorRT Model Connect
Para a NVIDIA, o termo desenvolvimento nativo de IA tem um sentido operacional específico: tratar as saídas produzidas por sistemas de IA como unidades de trabalho modulares e verificáveis. Em vez de aceitar automaticamente o que um agente produz, o projeto cria limites para que cada mudança possa ser testada, comparada, revisada e, se necessário, revertida.
Isso não significa que a IA escreva tudo ou que o julgamento humano desapareça. Os agentes exploram possibilidades e produzem candidatos, enquanto testes, benchmarks, comparações com referências e revisão humana determinam o que pode ser incorporado. A ideia se aproxima de uma linha de montagem: mais candidatos podem ser produzidos, mas somente aqueles que atravessam os controles de qualidade chegam ao produto final.
Como o desenvolvimento nativo de IA aproveita tarefas paralelas
O primeiro aprendizado apresentado pela NVIDIA é que nem todo trabalho de engenharia se beneficia da mesma maneira de vários agentes. Problemas com uma longa sequência de dependências continuam tendo um caminho crítico difícil de acelerar. Já projetos formados por muitos fluxos independentes podem aproveitar melhor a execução paralela.
O ecossistema de modelos de IA se encaixa relativamente bem nessa segunda categoria. Famílias de modelos, configurações, operadores, caminhos de execução e casos de validação podem ser investigados separadamente. No TensorRT Model Connect, cada família mantém sua implementação de referência, transforma checkpoints compatíveis em artefatos .bundle versionados e expõe APIs nativas em C++ voltadas a tarefas como texto, visão, áudio, difusão, segmentação, embeddings e previsão.
Segundo o material publicado, uma comparação referente ao lançamento público de 29 de julho de 2026 indicava cobertura de 128 famílias de modelos testadas em NVIDIA GB300. O número não prova, por si só, a produtividade dos agentes, mas ajuda a explicar por que uma arquitetura composta por unidades independentes pode crescer melhor do que uma única trilha de integração.
Por que o desenvolvimento nativo de IA usa objetivos, não receitas
Em vez de descrever cada passo da implementação, os trabalhos do projeto normalmente começam com um resultado esperado: adicionar suporte a uma família de modelos, corrigir uma diferença de precisão, melhorar um caminho de desempenho ou reforçar um contrato técnico.
Também são definidos os sinais que permitirão aceitar ou rejeitar a mudança. Eles podem incluir o comportamento de uma implementação de referência, testes específicos do projeto e restrições arquiteturais. O agente recebe o objetivo, os limites e as evidências necessárias, mas conserva alguma liberdade para escolher como chegar ao resultado.
Essa abordagem representa uma forma de desenvolvimento nativo de IA com orquestração mínima, mas não com controle mínimo. O agente pode explorar, implementar, testar, falhar e revisar dentro de uma tarefa isolada. Ainda assim, a alteração precisa atravessar as mesmas barreiras técnicas e arquiteturais aplicadas a qualquer outra contribuição.
O isolamento é a unidade de escala do desenvolvimento nativo de IA
Um dos pontos centrais do projeto é separar componentes que evoluem em velocidades diferentes. TensorRT e CUDA formam a base de execução, na qual compatibilidade, desempenho e confiabilidade são contratos importantes. O TensorRT Model Connect funciona como uma camada de integração mais rápida, conectando essa base a um ecossistema de modelos que muda continuamente.
Acima dela, cada família de modelos mantém conhecimentos específicos, como builders, pipelines de execução, kernels auxiliares, configurações e evidências de validação. Essa divisão reduz a necessidade de alterar vários componentes ao mesmo tempo e ajuda a conter uma falha dentro do espaço em que ela surgiu.
A NVIDIA reconhece que abstrações compartilhadas podem diminuir a quantidade de código, mas também podem aumentar conflitos de integração e ampliar o impacto de um erro. Por isso, alguma repetição entre famílias é considerada um preço aceitável para preservar a independência. Um comportamento só deve ser promovido para uma infraestrutura comum quando vários responsáveis precisarem do mesmo contrato sem pressupostos específicos.
O isolamento também é combinado com reversibilidade. Mudanças fáceis de avaliar e desfazer permitem testar hipóteses sem transformar cada experimento em uma decisão permanente. É uma diferença importante: velocidade serve para aprender mais rápido, não para eliminar as barreiras de qualidade.
Quando o código fica barato, a evidência do desenvolvimento nativo de IA fica mais importante
Agentes podem reduzir o custo de produzir implementações candidatas, mas não tornam a correção automática. Pelo contrário: quanto maior o volume de candidatos, maior pode ser a pressão sobre testes, revisão e infraestrutura de validação.
Uma das respostas do projeto é tornar as evidências compreensíveis para pessoas. Interfaces semânticas, como entradas e saídas de texto ou entradas de texto com imagens como resultado, permitem que um revisor faça uma verificação rápida do comportamento final. Essa inspeção não substitui os testes automatizados, mas evita que a análise termine em uma pilha de tensores e valores difíceis de interpretar.
Outra prática é permitir que os próprios agentes criem testes, sondas e procedimentos operacionais junto com o código. Quando uma falha é encontrada, ela deve ser reproduzida, transformada em uma nova proteção contra regressões e incorporada ao procedimento para tornar futuras execuções mais resistentes ao mesmo erro.
A NVIDIA também descreve uma relação mais adversarial entre desenvolvimento e controle de qualidade. A equipe de QA não atua apenas depois que uma implementação está pronta; ela tenta falsificar as afirmações feitas pelo código em um pipeline reproduzível. Os desenvolvedores, por sua vez, fortalecem tanto a implementação quanto o processo de validação quando uma inconsistência aparece.
O papel humano no desenvolvimento nativo de IA muda de lugar
Com agentes produzindo mais candidatos, o trabalho humano tende a se deslocar para decisões anteriores e mais abrangentes. Os engenheiros precisam escolher problemas que valem a pena, decidir se eles podem ser decompostos com segurança e estabelecer os critérios que transformarão uma saída não confiável em uma possível contribuição.
Isso não elimina a necessidade de inspecionar código ou investigar falhas. A diferença é que o julgamento humano passa a se concentrar também no desenho do sistema: definir intenções, determinar onde a independência é necessária, interpretar evidências anômalas e manter a responsabilidade pela decisão de lançamento.
Em outras palavras, o desenvolvimento nativo de IA não transfere a responsabilidade para o agente. Ele tenta organizar o processo para que agentes explorem, a evidência exponha problemas e pessoas decidam o que merece confiança.
Limitações ainda abertas no desenvolvimento nativo de IA
A própria NVIDIA ressalta que o TensorRT Model Connect está em prévia pública e que o modelo ainda está sendo testado e refinado. Nem toda tarefa de engenharia pode ser dividida em unidades independentes, e a orquestração mínima não é apresentada como uma solução universal.
O isolamento reduz o alcance de uma falha, mas não elimina riscos na infraestrutura compartilhada de compilação, execução, empacotamento e integração contínua. Além disso, implementações de referência são pontos de comparação úteis, não oráculos infalíveis. Os testes ainda precisam de invariantes independentes e tolerâncias revisadas com cuidado.
Outro limite é que o aumento no número de agentes pode elevar a demanda por validação mais rapidamente do que a quantidade de resultados aceitos. A maior parte das tarefas também continua sendo iniciada por pessoas. A descoberta automática de tarefas e a concorrência em larga escala aparecem como direções futuras, não como capacidades já comprovadas pelo projeto.
O que o TensorRT Model Connect pretende oferecer
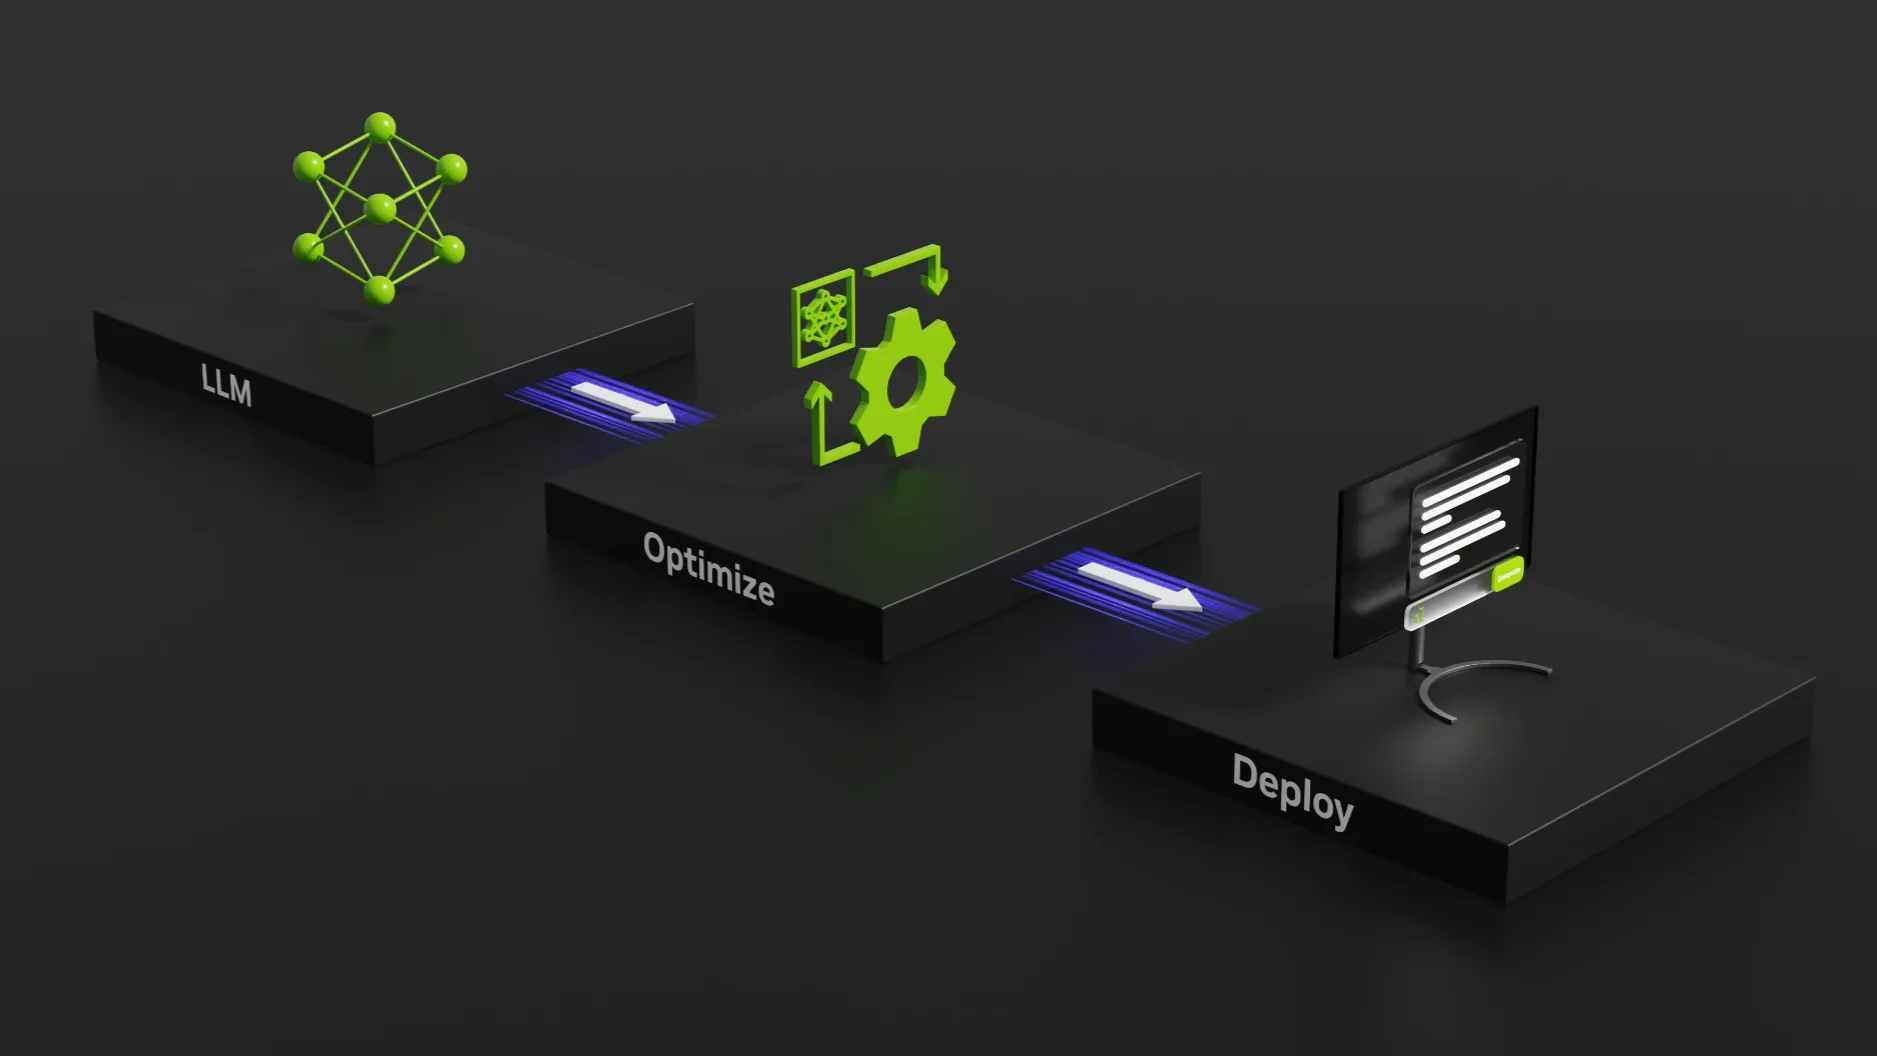
O objetivo do projeto não se limita ao sistema de inferência. A NVIDIA quer reduzir a barreira enfrentada por desenvolvedores que precisam avaliar e executar modelos em hardware da empresa, mas não necessariamente dominam todos os detalhes do TensorRT.
A proposta é criar um caminho entre um checkpoint do Hugging Face ou local, um bundle versionado e uma API nativa orientada à tarefa. Ao mesmo tempo, as implementações de cada família devem permanecer visíveis o suficiente para serem inspecionadas, estendidas e personalizadas.
Esse objetivo ainda é uma aspiração, e não uma promessa de compatibilidade atual com todos os modelos ou plataformas. O sucesso dependerá de equilibrar a redução da complexidade para o desenvolvedor com precisão, desempenho, confiabilidade e manutenção.
Conclusão: o desenvolvimento nativo de IA depende mais de evidências do que de velocidade
A lição central do caso da NVIDIA é que o desenvolvimento nativo de IA não nasce apenas da adoção de agentes de programação. Ele depende de uma arquitetura que permita trabalhar em paralelo sem espalhar falhas, de mudanças que possam ser revertidas e de validações capazes de transformar resultados incertos em decisões verificáveis.
O TensorRT Model Connect mostra uma tentativa concreta de aplicar esse princípio a um projeto de código aberto voltado a muitas famílias de modelos. Os agentes ajudam a explorar possibilidades, mas a arquitetura limita o alcance dos erros, os testes tornam as afirmações questionáveis e os humanos continuam responsáveis pelo propósito e pela liberação do software.
O detalhe que muda a discussão, portanto, é simples: produzir código mais rápido não é o mesmo que produzir software confiável mais rápido. A velocidade só se converte em avanço quando a capacidade de gerar candidatos vem acompanhada por evidências suficientes para decidir quais deles merecem continuar.