Tempo de leitura: 5 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. O ajuste fino do Nemotron foi usado pela NVIDIA para criar sistemas especializados em programação competitiva e demonstrações matemáticas, com resultados de nível ouro na IOI 2026 e na IMO 2026. A notícia chama atenção não apenas pelas pontuações, mas pela estratégia por trás delas: o modelo foi combinado com dados específicos, treinamento supervisionado, aprendizado por reforço e ciclos de geração, verificação e revisão.
Isso ajuda a responder uma questão importante sobre modelos de linguagem: será que um modelo generalista precisa ser completamente reconstruído para enfrentar tarefas de fronteira? Os resultados divulgados pela NVIDIA sugerem que, em alguns casos, uma especialização bem planejada pode ser mais importante do que criar uma nova base do zero.
Como o ajuste fino do Nemotron foi usado em duas competições diferentes
A IOI e a IMO exigem habilidades bastante distintas. Na Olimpíada Internacional de Informática, os participantes precisam desenvolver algoritmos e escrever código capaz de passar por testes ocultos dentro de limites rígidos de tempo e submissões. Já a Olimpíada Internacional de Matemática exige provas escritas em linguagem natural, com argumentos rigorosos e completos.
Mesmo assim, a NVIDIA aplicou uma receita semelhante aos dois desafios: começou com uma base Nemotron, reuniu dados específicos do domínio, aplicou métodos de pós-treinamento e criou um sistema de inferência capaz de avaliar e melhorar respostas. A abordagem mostra que o ajuste fino do Nemotron não foi tratado apenas como uma forma de treinar um checkpoint, mas como parte de um sistema maior.
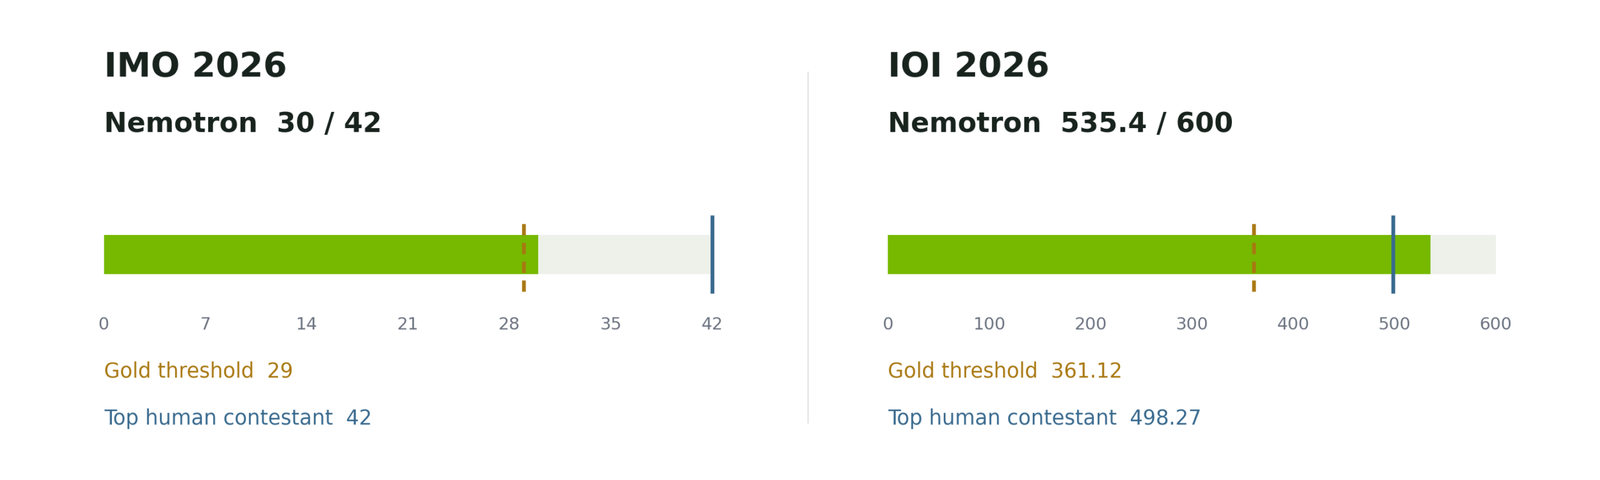
Na IOI 2026, o modelo Nemotron-3-Ultra-CC alcançou 535,4 pontos de 600, acima do limite de 361,12 pontos indicado para a medalha de ouro e também acima da maior pontuação humana informada pela NVIDIA, de 498,27. O resultado foi obtido em uma execução prospectiva, sob restrições de tempo, acesso à internet e submissões semelhantes às dos competidores humanos. A participação, porém, foi não oficial, sem supervisão, e não entrou no ranking da competição.
Na IMO 2026, o sistema alcançou 30 de 42 pontos, acima do limite oficial de 29 pontos para o ouro. Nesse caso, as provas enviadas foram avaliadas pelos corretores oficiais da olimpíada, segundo o relato publicado pela empresa.
O ajuste fino do Nemotron levou dados especializados à programação
Para a programação competitiva, as equipes organizaram 22 mil problemas e geraram traços sintéticos de raciocínio para treinar dois especialistas. O Nemotron-3-Nano-CC tinha 30 bilhões de parâmetros totais, com 3 bilhões ativos, enquanto o Nemotron-3-Ultra-CC tinha 550 bilhões de parâmetros totais e 55 bilhões ativos.
Os testes apresentados com problemas da IOI 2025 mostram como a especialização alterou o desempenho. O Nano passou de 130 pontos antes do pós-treinamento para 280 após o treinamento supervisionado e 291 depois do aprendizado por reforço. Com o GenCorrect, estratégia iterativa de gerar, avaliar e refinar soluções, chegou a 468 pontos, ultrapassando o limite de ouro de 438,3. O Ultra-CC alcançou 502 pontos com a mesma estratégia de inferência.
Um detalhe chama atenção: os ganhos não foram iguais em todas as escalas. No modelo Nano, o treinamento supervisionado concentrou a maior parte da melhora, enquanto o aprendizado por reforço trouxe um avanço menor, porém consistente. No modelo Ultra, uma única época de treinamento supervisionado foi suficiente para superar o Nano totalmente pós-treinado em avaliações de IOI, ICPC e LiveCodeBench Pro.
Essa combinação foi levada para o sistema usado na IOI 2026. O modelo não precisava apenas produzir uma resposta; ele também se beneficiava de um ciclo para encontrar erros, testar alternativas e aperfeiçoar o código. É uma diferença parecida com a existente entre pedir a alguém uma solução de primeira e permitir que essa pessoa execute testes antes de entregar o resultado.
O modelo competitivo citado pela NVIDIA está disponível no Hugging Face, enquanto a metodologia do GenCorrect é descrita no artigo técnico sobre a IOI.
O ajuste fino do Nemotron ensinou o sistema a provar e revisar
Na matemática, o treinamento foi direcionado para mais do que respostas finais. O conjunto supervisionado reuniu 414.890 exemplos filtrados por qualidade, correspondentes a 15.818 problemas de provas. Os dados incluíam geração, refinamento, verificação e metaverificação de argumentos.
Na prática, isso significa que o sistema foi treinado para construir uma prova, procurar lacunas, responder a críticas e avaliar se o raciocínio estava completo. Um segundo modelo foi treinado com aprendizado por reforço usando 9.597 problemas próximos da fronteira de capacidade do sistema.
Os especialistas apresentaram pontos fortes diferentes. O checkpoint supervisionado foi melhor na primeira rodada de busca, enquanto o modelo treinado com reforço obteve o melhor resultado individual geral. Em vez de escolher apenas um deles, a solução final combinou os dois com o modelo generalista.
Para cada problema da IMO, os modelos geravam provas candidatas, atribuíam notas, produziam críticas e refinavam as tentativas mais promissoras. Uma etapa posterior, com maior orçamento computacional, selecionava a submissão final. Todo o processo ocorreu em linguagem natural, sem provador formal, ferramentas externas ou acesso à internet.
Essa linha de pesquisa se aproxima de outros esforços recentes para tornar provas matemáticas mais verificáveis, como os avanços em IA na matemática com provas verificáveis. A diferença, neste caso, está no uso de um fluxo de busca e revisão baseado em múltiplos checkpoints especializados.
O que o ajuste fino do Nemotron revela sobre modelos especializados
Os resultados apresentados não indicam que o treinamento adicional, sozinho, tenha produzido as medalhas. Na IOI, o GenCorrect ampliou os ganhos obtidos com a especialização ao aplicar várias rodadas de feedback. Na IMO, a combinação de modelos com habilidades complementares foi mais útil do que simplesmente gerar muitas amostras a partir de um único checkpoint.
A conclusão mais ampla é que desempenho de fronteira depende da coordenação entre modelo, dados e inferência. O ajuste fino fornece candidatos melhores; o sistema de inferência ajuda a verificar esses candidatos; e o ciclo de revisão aumenta a chance de que uma solução promissora seja corrigida antes da resposta final.
A NVIDIA também disponibilizou materiais para reprodução e pesquisa, incluindo checkpoints, conjuntos de dados e o Nemotron-IMO-Bench, com 200 problemas de nível olímpico. O repositório NeMo-Skills reúne ainda o pipeline de inferência, prompts, provas submetidas e um guia de início rápido.
Isso não elimina as limitações do anúncio. O resultado da IOI foi não oficial, e os números dependem de sistemas com grande orçamento de treinamento e inferência. Ainda assim, a experiência oferece uma evidência relevante de que modelos abertos podem ser adaptados a domínios muito exigentes sem que cada novo desafio exija uma fundação completamente diferente.
Conclusão: o que o ajuste fino do Nemotron realmente demonstra
O ajuste fino do Nemotron alcançou resultados de nível ouro em programação e matemática porque foi integrado a uma estratégia mais completa. A NVIDIA combinou dados especializados, treinamento supervisionado, aprendizado por reforço e mecanismos de geração, avaliação e refinamento.
A resposta para a pergunta apresentada no início é, portanto, mais específica do que um simples “sim” ou “não”. Um modelo generalista pode se tornar um especialista de alto nível sem ser reconstruído do zero, mas isso exige muito mais do que alterar seus pesos. É necessário escolher problemas adequados, produzir exemplos de qualidade e criar uma forma confiável de revisar as respostas.
O ponto central talvez seja este: em tarefas difíceis, a inteligência do modelo é apenas uma parte do sistema. O restante está no processo usado para fazer perguntas, detectar erros e tentar novamente. É nesse espaço entre treinamento e inferência que o Nemotron encontrou seus resultados mais expressivos.