Tempo de leitura: 7 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. A ServiceNow apresentou o AutoSynthData, um sistema criado para transformar falhas de agentes de IA em novos dados de treinamento. A proposta parte de um problema conhecido em ambientes corporativos: um modelo pode ser competente em termos gerais e ainda assim falhar diante de ferramentas, regras, sistemas e estados de dados específicos de uma empresa.
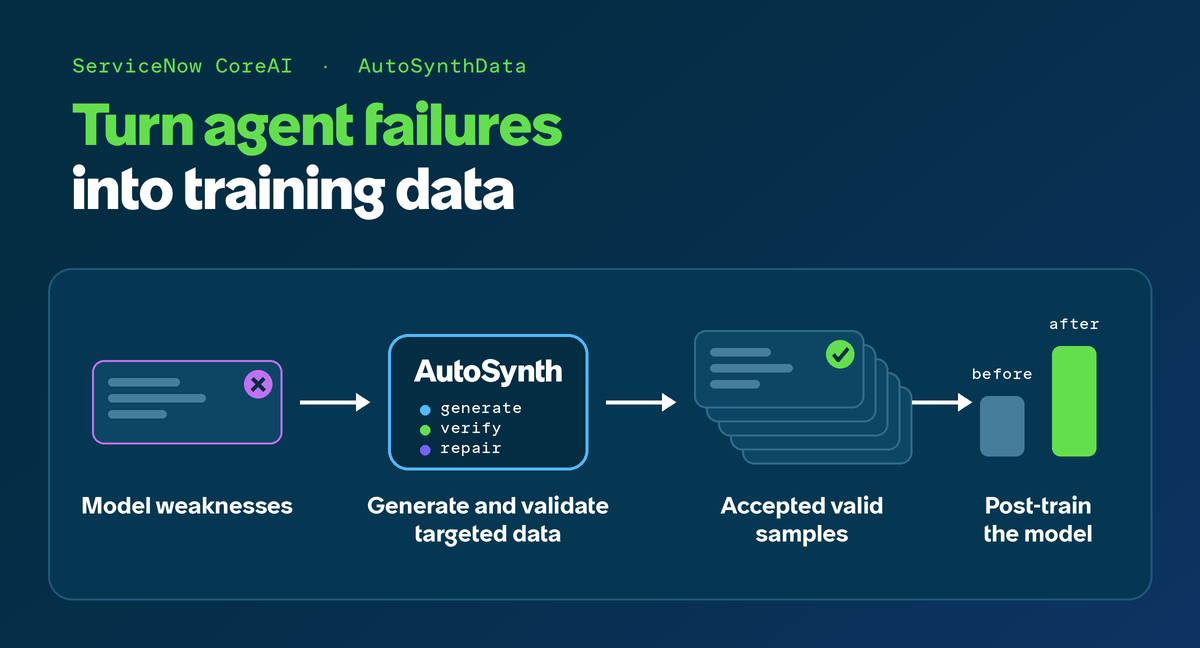
Em vez de simplesmente gerar tarefas artificiais em grande volume, o AutoSynthData tenta descobrir o que o modelo ainda não consegue fazer, criar situações realistas para exercitar essa capacidade e verificar se cada exemplo realmente funciona. A diferença parece sutil, mas é fundamental: dados sintéticos de qualidade não são apenas pedidos plausíveis escritos por um modelo de linguagem.
O sistema foi apresentado em um artigo publicado pela Hugging Face em 2 de outubro de 2026. Nos experimentos descritos, a abordagem foi aplicada ao EnterpriseOps Gym, um ambiente empresarial com tarefas que envolvem ferramentas, fluxos de trabalho e mudanças de estado.
Como o AutoSynthData cria dados para agentes empresariais
O AutoSynthData começa avaliando um modelo-alvo dentro do ambiente em que ele deverá operar. Essas avaliações revelam padrões de falha: ferramentas usadas incorretamente, etapas omitidas, combinações de ações que não funcionam ou restrições que o agente não consegue respeitar.
Um modelo mais forte atua como professor. Ele ajuda a identificar quais tarefas são solucionáveis e como seria um comportamento bem-sucedido. Essas informações são resumidas em especificações de capacidade, chamadas de capability specification cards. O gerador usa esses cartões para criar novas tarefas, mas não recebe os prompts, entidades, trajetórias ou verificadores originais das avaliações.
Essa separação é importante porque reduz o risco de o sistema apenas memorizar exemplos antigos. As tarefas novas variam em aspectos como:
- pedido feito pelo usuário;
- estado inicial do ambiente;
- entidades envolvidas;
- combinação de ferramentas;
- composição do fluxo de trabalho;
- redação e nível de dificuldade.
O objetivo é encontrar tarefas que sejam realistas e executáveis, mas ainda difíceis para o modelo-alvo. Tarefas que o agente já resolve com facilidade oferecem pouco sinal para o treinamento. Já tarefas impossíveis ou desconectadas do trabalho real apenas introduzem ruído.
AutoSynthData verifica se cada tarefa realmente funciona
Gerar uma solicitação convincente não basta. Uma tarefa pode depender de uma ferramenta inexistente, conter uma transição de estado impossível ou ter um verificador que aceite um resultado incorreto. Por isso, o AutoSynthData submete cada candidato a uma sequência de validações.
Validação positiva e negativa no AutoSynthData
A validação positiva executa a trajetória de referência no ambiente e verifica se o estado final atende aos critérios definidos. Ela ajuda a encontrar inconsistências entre o pedido, o estado inicial, a solução e o verificador.
Já a validação negativa testa resultados incorretos. O sistema pode modificar partes do resultado esperado para confirmar que esses estados realmente são rejeitados. Esse passo combate verificadores permissivos demais, que poderiam declarar sucesso mesmo quando o agente não cumpriu a tarefa.
Quando uma amostra falha, um crítico analisa o problema. A falha pode estar na construção da tarefa, na trajetória de referência, na lógica do verificador ou na própria compatibilidade com o ambiente. O candidato pode ser reparado dentro de um limite definido de tentativas; depois disso, ele é descartado caso não passe novamente pelas verificações.
O controle também acontece no nível do conjunto
Mesmo que cada exemplo individual seja válido, o conjunto inteiro pode ser repetitivo ou desequilibrado. O AutoSynthData faz uma revisão das amostras aceitas e rejeitadas para descobrir famílias de tarefas super-representadas, capacidades ausentes e padrões recorrentes de falha.
Com essas informações, o controlador reduz a geração em regiões já cobertas e direciona novos esforços para lacunas do conjunto. É uma lógica parecida com ajustar uma dieta: não adianta continuar adicionando o mesmo ingrediente apenas porque ele está disponível.
O material também descreve duas fases de construção. A fase Target cria o conjunto principal de amostras a partir das especificações de capacidade. Depois, a fase Multiply amplia esse conjunto com variantes novas. Cada variante precisa ter seu próprio pedido, estado, configuração de entidades, trajetória e verificador, além de passar pelas mesmas validações.
AutoSynthData move o treinamento para a fronteira de capacidade
O sistema trata a geração de dados como uma busca pela fronteira de capacidade do modelo. Essa fronteira reúne tarefas difíceis o bastante para expor limitações, mas solucionáveis o bastante para que o professor forneça demonstrações confiáveis.
Nos testes descritos, a configuração favoreceu tarefas que o modelo-alvo resolvia em no máximo uma de três tentativas, enquanto o solucionador mais forte deveria resolvê-las em pelo menos duas de três. Depois do ajuste fino, o modelo era avaliado novamente no mesmo ambiente. As tarefas que ele passou a resolver de forma consistente deixavam de ser prioridade, enquanto as falhas persistentes orientavam a próxima rodada de geração.
Esse ciclo lembra um professor que muda os exercícios conforme o aluno avança. Repetir indefinidamente as questões já dominadas pode aumentar o volume do material, mas não necessariamente melhora a aprendizagem.
Resultados no EnterpriseOps Gym
No domínio Hybrid do EnterpriseOps Gym, a equipe usou o Gemma-4-26B-A4B-it como modelo-alvo e o Qwen3.8-27B como professor. O AutoSynthData gerou 2.000 amostras sintéticas em aproximadamente 18 horas.
O melhor checkpoint, correspondente ao quinto ciclo de treinamento, aumentou o mean Pass@1 em 7,2 pontos percentuais, o que representa uma melhoria relativa de 35%. A taxa de sucesso medida pelo verificador passou de 63,01% para 68,55%. Segundo o artigo, o resultado fechou 59% da diferença original de Pass@1 entre o Gemma e o modelo de referência.
No domínio ITSM, o Gemma foi treinado com demonstrações produzidas pelo DeepSeek-V4.1-Flash. Foram geradas 1.994 amostras em 66 horas, e o desempenho médio de Pass@1 subiu de 18,77% para 27,18%.
Esses números descrevem experimentos em um ambiente controlado, não uma garantia de que qualquer agente empresarial terá o mesmo ganho. Ainda assim, eles mostram uma direção relevante: adaptar o treinamento às falhas observadas no ambiente pode ser mais útil do que simplesmente ampliar um conjunto genérico de exemplos.
A estratégia também pode interessar a quem acompanha a infraestrutura e a segurança de agentes. No Planksnet, já discutimos como plataformas para monitorar a segurança de agentes de IA tentam controlar o comportamento desses sistemas com políticas verificáveis. A lógica é complementar: o AutoSynthData procura melhorar o que o agente aprende, enquanto mecanismos de controle ajudam a limitar o que ele pode fazer.
O que o AutoSynthData revela sobre o treinamento de agentes
A principal contribuição do AutoSynthData não está apenas em gerar mais tarefas. Ela está em conectar quatro elementos que muitas vezes são tratados separadamente: avaliação do modelo, geração de dados, execução no ambiente e verificação do resultado.
Sem avaliação, o sistema não sabe o que ensinar. Sem execução, não há certeza de que a tarefa é possível. Sem um verificador sólido, o treinamento pode recompensar comportamentos errados. E sem revisão do conjunto, a geração pode produzir milhares de exemplos parecidos, como uma fábrica que funciona perfeitamente, mas fabrica sempre o mesmo parafuso.
O trabalho também aponta uma possível extensão para aprendizado por reforço. Nesse cenário, o sistema poderia gerar tarefas que desafiam a política atual, oferecer um sinal de aprendizagem confiável, treinar o agente e mover novamente o alvo conforme suas capacidades mudassem. A equipe afirma que pretende testar essa fronteira calibrada por dificuldade além do ajuste fino supervisionado.
O ponto mais importante é que agentes empresariais não vivem apenas de conhecimento geral. Eles precisam operar dentro de sistemas específicos, obedecer políticas, usar ferramentas corretamente e produzir mudanças verificáveis no estado do ambiente. O AutoSynthData tenta transformar essas exigências em um processo contínuo de aprendizagem.
Em outras palavras, a resposta para o problema apresentado no início não é simplesmente gerar mais dados. É gerar os dados certos para as falhas que ainda importam, validar cada tarefa e repetir o ciclo conforme o modelo evolui. Se essa abordagem se mostrar robusta fora dos ambientes controlados, ela poderá ajudar empresas a treinar agentes para fluxos de trabalho próprios sem depender apenas de conjuntos genéricos.