Tempo de leitura: 5 minutos
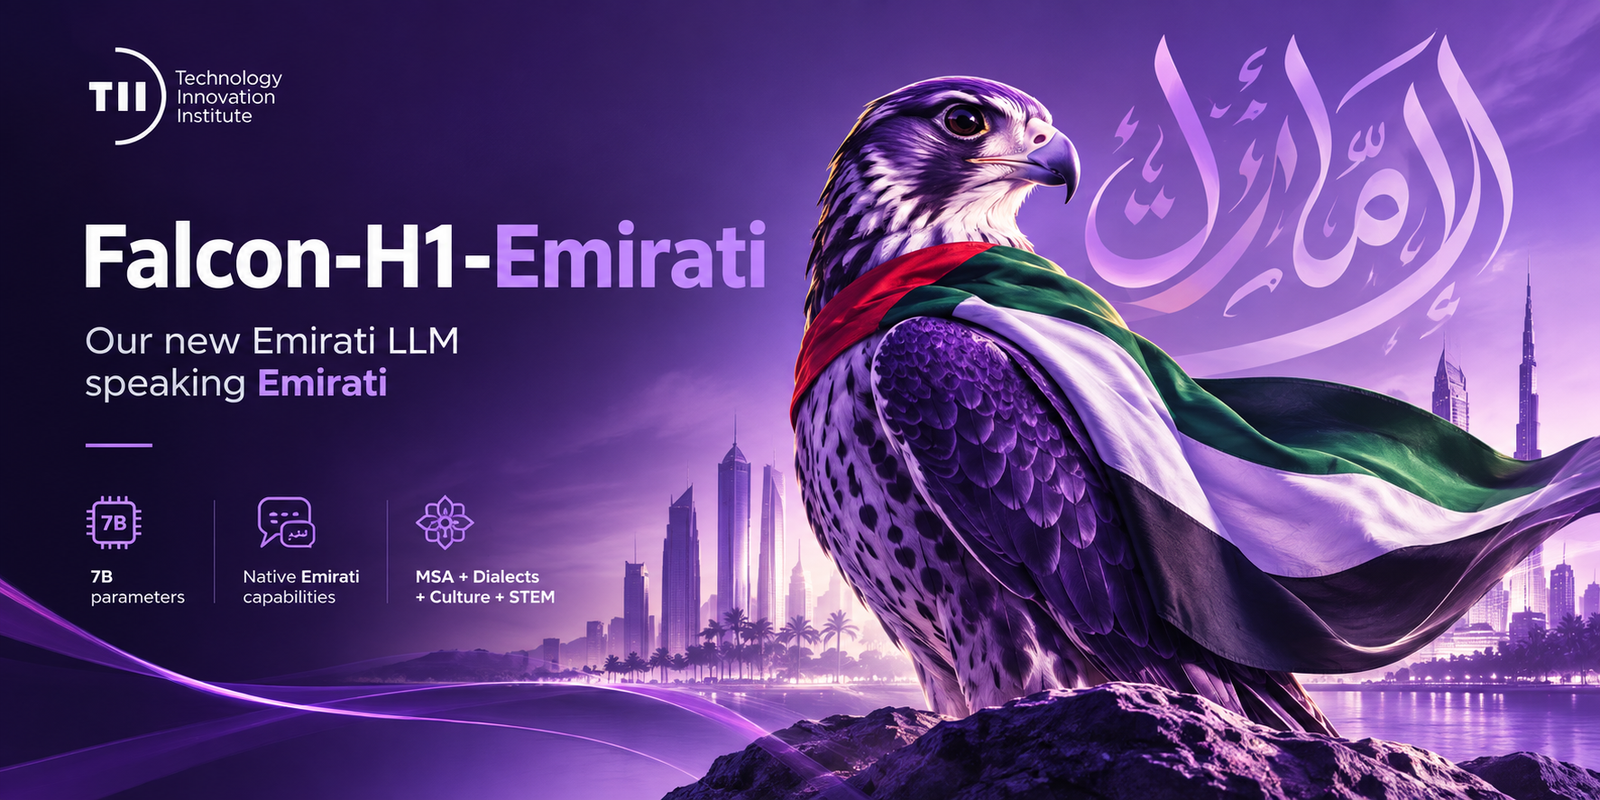
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. O Falcon-Emirati-7B foi apresentado como um modelo de linguagem especializado no árabe emiradense, um dialeto cuja compreensão depende de muito mais do que traduzir palavras corretamente. Piadas, provérbios, poesia nabati e referências culturais podem perder completamente o sentido quando interpretados apenas pelo árabe padrão moderno.
Desenvolvido pelo Technology Innovation Institute sobre a família Falcon-H1-Arabic, o modelo tenta resolver justamente esse problema: responder com vocabulário, tom e contexto cultural mais próximos dos usados por falantes dos Emirados Árabes Unidos. O resultado divulgado pela equipe chama atenção, mas também revela por que adaptar um modelo a um dialeto é uma tarefa bem mais difícil do que parece.
Falcon-Emirati-7B foi criado para lidar com um dialeto específico
O árabe emiradense é usado principalmente em conversas do dia a dia e aparece muito menos na internet do que o árabe padrão moderno. Isso reduz a quantidade de textos autênticos disponíveis para treinamento. Além disso, boa parte do significado está escondida em expressões idiomáticas, referências históricas, normas sociais e formas de falar que não podem ser reproduzidas por uma tradução palavra por palavra.
O Falcon-Emirati-7B parte do Falcon-H1-Arabic, uma família que combina modelos de espaço de estados Mamba e atenção Transformer em sua arquitetura. Segundo a equipe, essa combinação busca preservar eficiência em sequências longas sem abrir mão da capacidade de capturar relações distantes no texto.
A escolha da versão de 7 bilhões de parâmetros foi apresentada como um equilíbrio entre qualidade e custo. Um modelo maior poderia oferecer ganhos adicionais, mas exigiria mais recursos para treinamento e operação. Já uma versão menor teria menos capacidade para absorver as nuances linguísticas e culturais pretendidas.
Como o Falcon-Emirati-7B aprendeu vocabulário e contexto cultural
A adaptação foi feita com uma combinação de dados, em vez de depender apenas de textos sintéticos. A equipe reuniu conteúdo escrito originalmente em árabe emiradense em sites e fóruns, procurando preservar expressões naturais e a alternância comum entre o dialeto e o árabe padrão moderno.
Também foram utilizados materiais em árabe padrão sobre a cultura, a história, os costumes e as normas sociais dos Emirados. Esses textos não ensinam necessariamente o modelo a escrever no dialeto, mas ajudam a construir o contexto necessário para falar sobre temas locais sem tratar a cultura como uma simples lista de palavras.
Por fim, os pesquisadores produziram dados sintéticos orientados por glossários, dicionários e regras de estilo específicos do emiradense. Essa etapa teve uma função importante: ampliar a cobertura de assuntos de conversas cotidianas sem deixar que o modelo passasse a produzir um árabe genérico com aparência de dialeto do Golfo.
O desafio foi encontrar a combinação certa
Como não existe uma receita estabelecida para transformar um modelo de árabe geral em um especialista em dialeto, a equipe testou diferentes misturas de dados e etapas de treinamento. O processo incluiu pré-treinamento contínuo, ajuste supervisionado e estratégias de otimização por preferência.
A avaliação também combinou métricas automáticas e análise humana. Falantes nativos observaram naturalidade, tom e adequação cultural, aspectos que uma pontuação convencional dificilmente captura. É a diferença entre reconhecer a resposta correta e realmente soar como alguém que conhece o contexto.
Falcon-Emirati-7B alcançou 84,83% no benchmark Alyah
Na avaliação divulgada pela equipe, o Falcon-Emirati-7B obteve 84,83% no Alyah, benchmark criado para medir a capacidade de modelos de linguagem em árabe emiradense. O conjunto tem 1.173 questões elaboradas com participação de falantes nativos e cobre saudações, etiqueta, linguagem figurada, patrimônio cultural e poesia emiradense.
O resultado ficou à frente dos demais modelos árabes e multilíngues comparados no teste apresentado. A conclusão mais interessante, porém, não é simplesmente que um modelo menor superou modelos maiores. Ela sugere que tamanho, por si só, não garante competência em um dialeto específico. Sem dados e avaliações direcionados, um modelo pode saber árabe e ainda responder quase sempre em árabe padrão moderno.
Em uma segunda avaliação, respostas abertas foram analisadas pelo Gemini 3.7 Flash em duas dimensões: correção do conteúdo e fidelidade ao dialeto emiradense. O Falcon-Emirati-7B obteve pontuação parcial de 0,52 em fidelidade ao dialeto, enquanto os demais modelos comparados ficaram entre 0,05 e praticamente zero, segundo os números apresentados no anúncio.
Falcon-Emirati-7B também foi avaliado por compreensão cultural
O modelo foi testado ainda em um conjunto de cenários sobre a cultura dos Emirados, com perguntas que exigiam escolher a resposta mais apropriada em diferentes situações sociais. Nesse teste, a equipe informou uma precisão de 85,57% para o Falcon-Emirati-7B, contra 83,39% do ALLaM-7B, 73,79% do Jais-2-8B e 71,50% do Fanar-2-27B.
Esses resultados devem ser lidos dentro do contexto da avaliação divulgada pelos próprios desenvolvedores. Eles indicam uma vantagem nas tarefas selecionadas, mas não provam que o modelo compreenda toda a diversidade cultural dos Emirados ou que esteja livre de erros. A própria equipe alerta que expressões raras, referências muito locais e situações sensíveis ainda podem gerar respostas inadequadas.
Os exemplos apresentados mostram essa diferença na prática. Em prompts sobre saudações, o modelo respondeu em um registro emiradense, enquanto concorrentes recorreram ao árabe padrão moderno. Em perguntas sobre tradições marítimas, tipos de tâmaras e história local, a adaptação cultural também foi destacada — embora os exemplos sejam demonstrações produzidas pelos desenvolvedores, e não uma validação independente de cada resposta.
O que o Falcon-Emirati-7B representa para os modelos de linguagem
O lançamento reforça uma ideia que costuma ser esquecida na corrida por modelos maiores: competência linguística não é apenas saber gramática e vocabulário. Um sistema pode responder corretamente e ainda assim usar o registro errado, ignorar uma referência cultural ou produzir uma frase que nenhum falante nativo diria daquela maneira.
Para aplicações voltadas a atendimento, educação, preservação cultural e serviços públicos, essa diferença pode ser decisiva. Um chatbot que entende a pergunta, mas responde em um registro distante ou inadequado, cria uma experiência parecida com a de conversar com alguém que traduziu tudo corretamente e entendeu quase nada.
O Falcon-Emirati-7B não elimina esse problema, mas mostra um caminho: combinar dados autênticos, conhecimento cultural, geração sintética controlada e avaliação feita por falantes nativos. A questão que fica é se essa estratégia poderá ser aplicada com a mesma qualidade a outros dialetos que também têm poucos dados disponíveis.
Conclusão: Falcon-Emirati-7B mostra que contexto importa tanto quanto escala
O Falcon-Emirati-7B foi anunciado como um modelo especializado no árabe emiradense e apresentou resultados fortes nos benchmarks divulgados pela equipe, especialmente na capacidade de responder no dialeto esperado e reconhecer contextos culturais dos Emirados.
A principal lição não está apenas nos 84,83% do Alyah ou nos 85,57% no teste cultural. Está no processo necessário para chegar a esses números: coletar linguagem autêntica, preservar conhecimento local, controlar dados sintéticos e ouvir falantes nativos. Em dialetos, uma resposta tecnicamente correta pode continuar soando errada — e essa diferença é exatamente o tipo de nuance que modelos generalistas costumam deixar escapar.
Como acontece com qualquer modelo de linguagem, os resultados precisam ser verificados em usos reais antes de aplicações sensíveis. Ainda assim, o lançamento indica que o futuro dos modelos multilíngues talvez dependa menos de falar muitas línguas superficialmente e mais de compreender, com cuidado, como cada comunidade realmente usa a sua.