Tempo de leitura: 5 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. A Liquid AI anunciou, em 24 de setembro de 2026, o LFM2.5-VL-DSpark, um modelo experimental criado para acelerar a inferência do modelo de visão e linguagem LFM2.5-VL-3B. A proposta é interessante porque promete reduzir o tempo de geração sem alterar a qualidade da resposta, mantendo o modelo adequado para execução em dispositivos locais e GPUs.
O ganho não vem de simplesmente tornar o modelo principal maior ou mais potente. O LFM2.5-VL-DSpark adiciona um modelo auxiliar que antecipa blocos de tokens, enquanto o modelo original verifica essas previsões. É uma estratégia conhecida como decodificação especulativa, mas sua aplicação em modelos que analisam imagens traz desafios próprios. E é justamente nessa diferença entre acelerar a geração e acelerar toda a resposta que está o ponto mais importante do anúncio.
Como o LFM2.5-VL-DSpark acelera a inferência
O LFM2.5-VL-DSpark funciona como um rascunhista conectado ao LFM2.5-VL-3B. Em vez de o modelo principal gerar cada token individualmente, o componente auxiliar propõe um bloco de tokens com base nos estados internos capturados em camadas específicas. O modelo maior então verifica as propostas e aceita as que forem compatíveis.
Na prática, é como ter alguém preenchendo antecipadamente parte de uma resposta para que um revisor precise apenas confirmar o que está correto. Quando as previsões são boas, várias etapas podem ser validadas de uma vez. Quando não são, o modelo-alvo mantém o controle e corrige o caminho. Segundo a Liquid AI, a verificação é exata: em uma geração determinística, a saída deve ser equivalente à obtida pelo modelo principal sem especulação.
O rascunhista foi construído com uma arquitetura simplificada de atenção, quatro camadas e bloco de nove tokens durante o treinamento. Para a inferência, a empresa recomenda blocos de oito ou nove tokens, dependendo do hardware utilizado.
O custo adicional do LFM2.5-VL-DSpark é relativamente pequeno
O LFM2.5-VL-DSpark adiciona aproximadamente 280 milhões de parâmetros ao modelo de 3 bilhões de parâmetros. Isso representa um aumento de 8,9% no número total de parâmetros implantados, segundo os dados divulgados pela Liquid AI.
Esse acréscimo é dividido entre a pilha de decodificação, a projeção dos estados internos, o chamado Markov head e componentes de normalização e confiança. A ideia é trocar uma pequena quantidade de memória por uma redução maior no tempo de decodificação.
Essa troca pode fazer sentido especialmente em dispositivos locais, onde cada segundo de inferência pesa mais na experiência do usuário. O modelo está disponível em formatos Safetensors e GGUF, o que facilita sua integração a diferentes fluxos de execução local. Esse movimento também se conecta à aproximação entre ecossistemas de modelos abertos e ferramentas como o formato GGUF e o llama.cpp.
Resultados de velocidade do LFM2.5-VL-DSpark em CPU e GPU
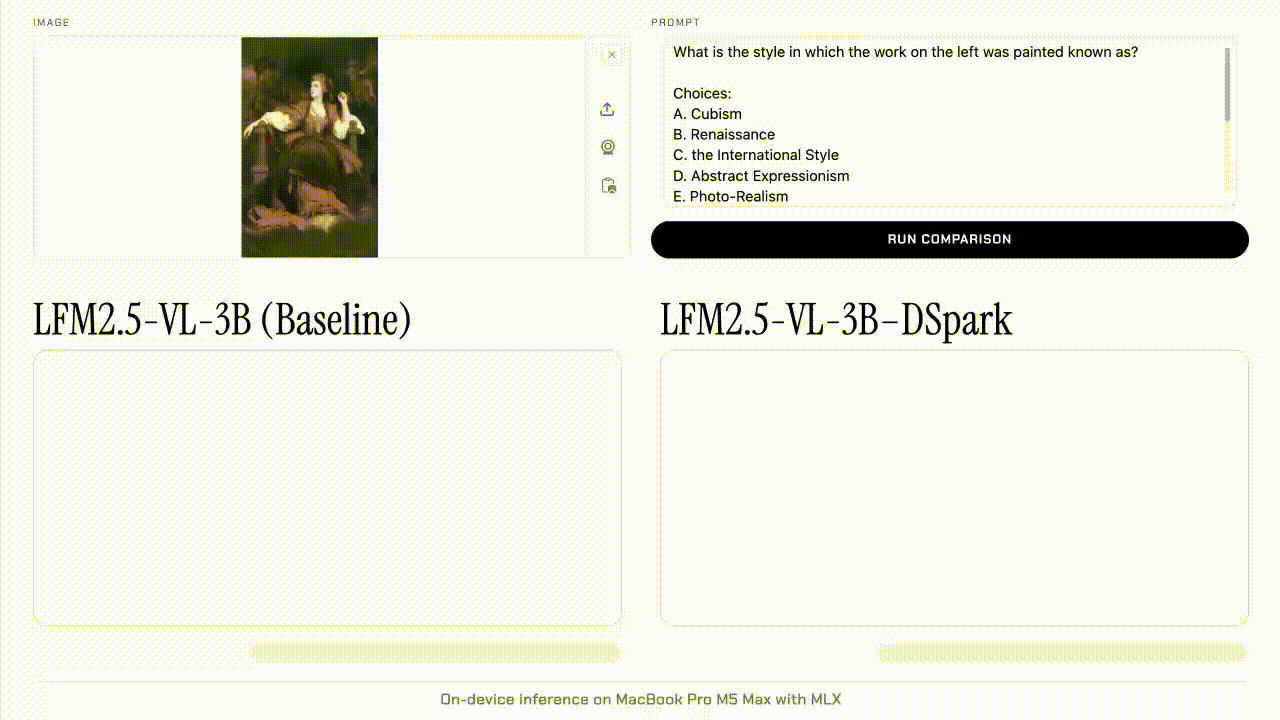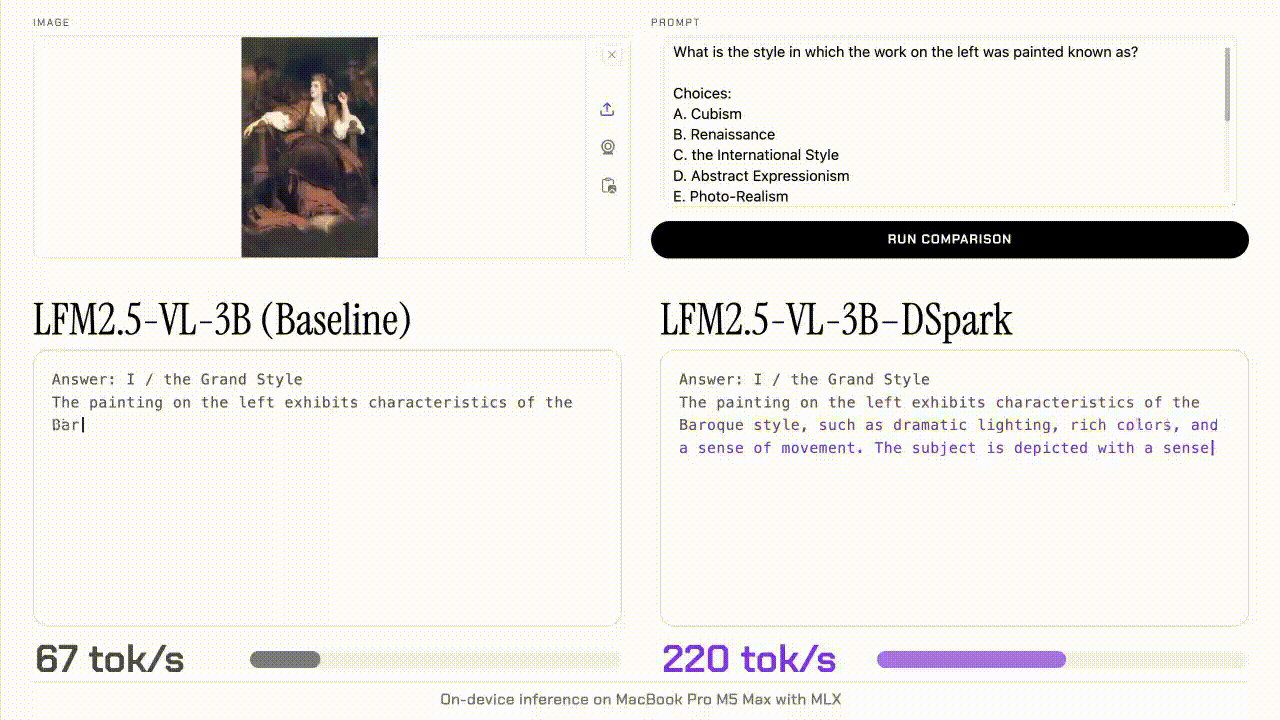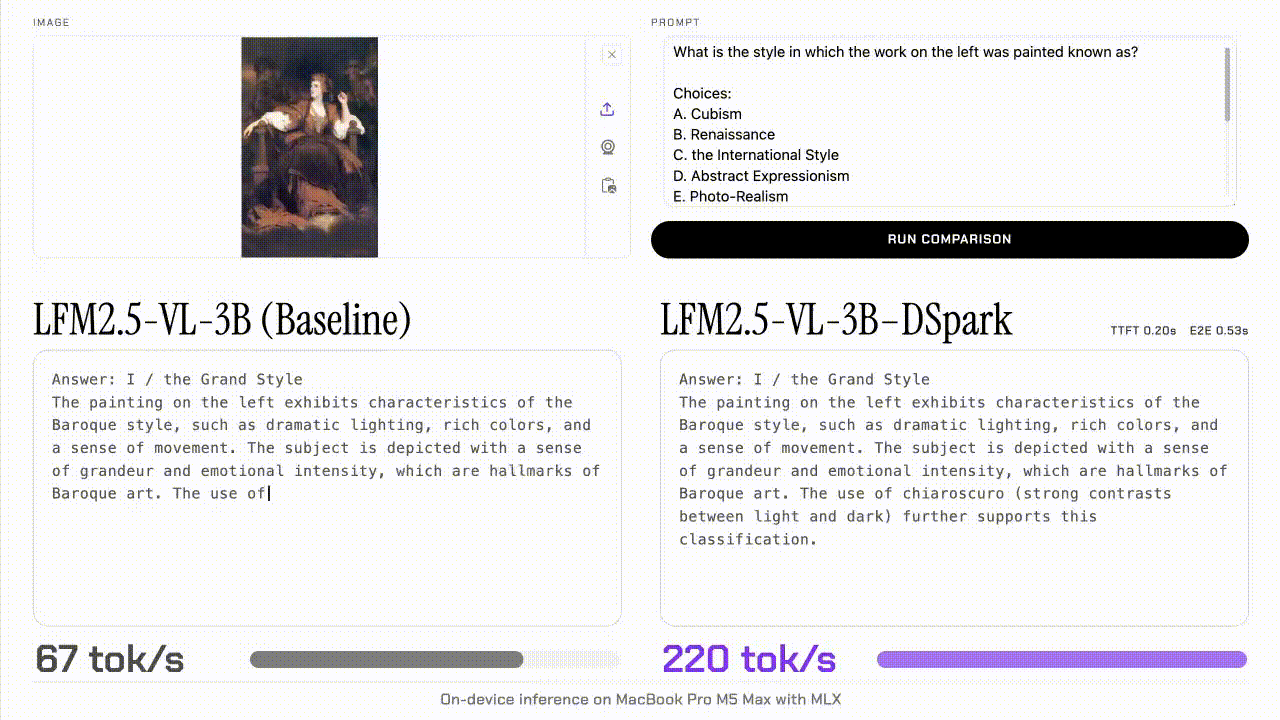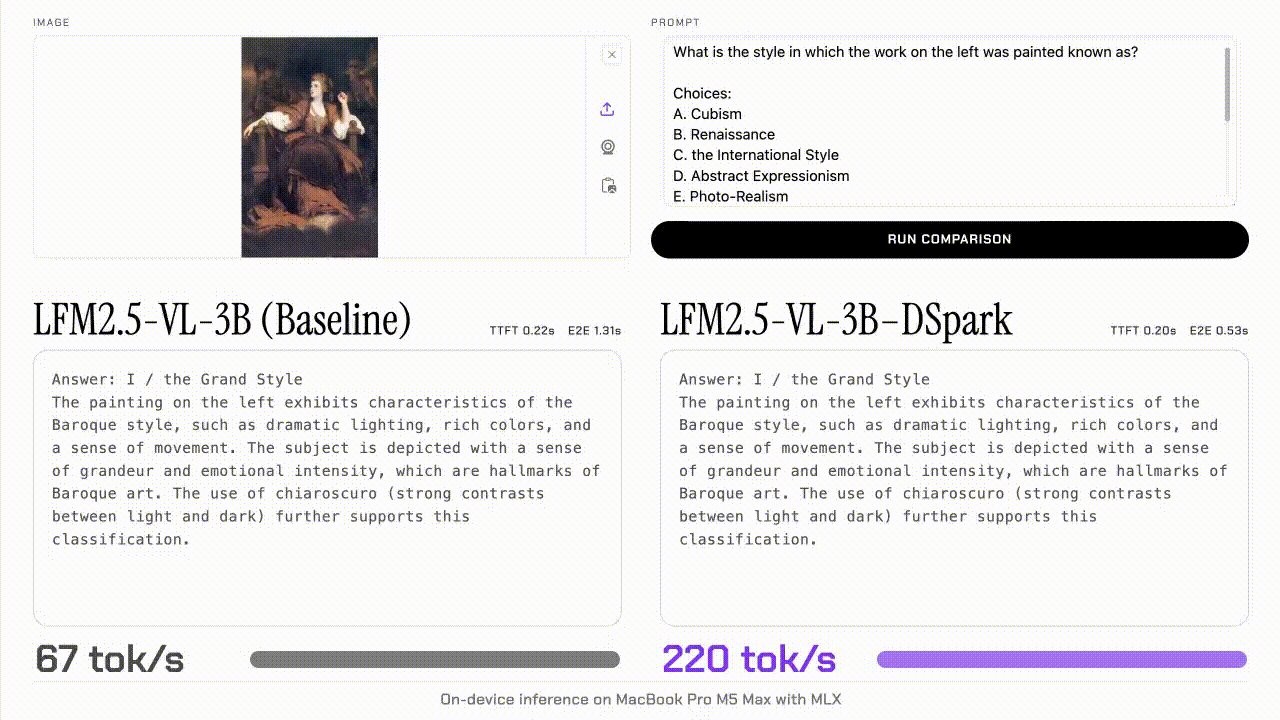
Nos testes apresentados, o LFM2.5-VL-DSpark alcançou aceleração de decodificação de até 3,13 vezes em um M5 Max usando MLX. Os ganhos de ponta a ponta, que incluem outras etapas da resposta, chegaram a 2,62 vezes.
Com llama.cpp em um M3 Ultra, a decodificação ficou entre 1,57 e 2,14 vezes mais rápida, enquanto a latência total melhorou entre 1,30 e 1,77 vez. Em uma GPU H100, a Liquid AI informou ganhos de até 2,66 vezes na decodificação e de até 2,27 vezes no resultado de ponta a ponta.
As medições foram realizadas em seis tarefas de visão: perguntas e respostas gerais sobre imagens, leitura de texto em imagens, geração de legendas, perguntas sobre gráficos, raciocínio complexo e conversas com múltiplas interações. Os testes seguiram o benchmark MMSpec, citado no anúncio original.
Os números, no entanto, não significam que toda solicitação ficará automaticamente três vezes mais rápida. A diferença entre a aceleração da decodificação e a melhora total da resposta mostra que o resultado depende do tipo de tarefa e do hardware. Em um cenário de execução local de IA, por exemplo, o tempo de processamento da imagem pode ser uma parte relevante da espera.
Por que o LFM2.5-VL-DSpark não acelera todas as etapas
Modelos de visão e linguagem precisam fazer mais do que gerar texto. Primeiro, a imagem passa por um codificador visual. Depois, os tokens visuais e o texto do prompt são processados pelo componente de linguagem. Só então começa a etapa de decodificação, que é justamente a parte acelerada pelo método especulativo.
Isso cria uma limitação importante. Se o carregamento da imagem e o processamento inicial consumirem grande parte do tempo total, uma aceleração expressiva na geração terá um efeito mais discreto na latência final. A Liquid AI relaciona esse comportamento à lei de Amdahl: o ganho geral de um sistema é limitado pelas partes que não foram aceleradas.
Imagine uma resposta que leve dez segundos, sendo seis segundos gastos no processamento visual e quatro na geração dos tokens. Mesmo que a geração fique duas vezes mais rápida, o tempo total não cairá pela metade, porque os seis segundos iniciais continuam existindo. O LFM2.5-VL-DSpark pode reduzir bastante o tempo de decodificação, mas não elimina o custo do codificador de visão nem do prefill.
Onde o LFM2.5-VL-DSpark pode ser executado
A Liquid AI anunciou suporte desde o primeiro dia para três caminhos de execução: llama.cpp, MLX-VLM e SGLang. No caso do SGLang, é necessário utilizar uma versão com suporte ao DSpark para modelos LFM2. Para llama.cpp e MLX-VLM, também são necessárias versões compatíveis com as respectivas integrações.
O modelo pode ser iniciado com um rascunhista associado ao modelo principal e consultado por meio de uma API compatível com a interface da OpenAI quando executado com SGLang. O tamanho do bloco é obtido a partir dos arquivos de configuração ou dos metadados do modelo, dependendo da ferramenta.
A disponibilidade em diferentes formatos reforça a estratégia da Liquid AI de levar modelos de visão e linguagem para além de grandes servidores. A comunidade que acompanha a execução local de IA com MLX também pode encontrar nesse tipo de integração uma alternativa para testar modelos multimodais em dispositivos da Apple.
O que o lançamento do LFM2.5-VL-DSpark representa
O LFM2.5-VL-DSpark mostra que melhorar a velocidade de modelos multimodais não depende apenas de reduzir parâmetros ou produzir uma nova versão do modelo principal. A decodificação especulativa oferece outro caminho: manter a qualidade do alvo e usar um componente menor para antecipar parte do trabalho.
O benefício real, porém, precisa ser analisado de acordo com a tarefa. Aplicações que geram respostas longas podem aproveitar mais a aceleração da decodificação, enquanto fluxos dominados pelo processamento inicial da imagem tendem a apresentar ganhos menores na latência total.
Por enquanto, trata-se de um lançamento experimental, com resultados divulgados pela própria Liquid AI e sujeito a diferenças entre hardware, biblioteca, configuração e tipo de entrada. Ainda assim, o LFM2.5-VL-DSpark aponta para uma direção relevante: modelos de visão e linguagem mais rápidos podem se tornar mais práticos em computadores pessoais e dispositivos de borda, sem depender exclusivamente de infraestrutura em nuvem.
Em outras palavras, a resposta para a pergunta inicial é simples, mas não trivial: o LFM2.5-VL-DSpark acelera principalmente a geração, não todo o caminho percorrido por uma imagem até a resposta. Quando essa distinção é levada em conta, os resultados deixam de parecer uma promessa genérica de velocidade e passam a indicar onde a técnica realmente pode fazer diferença.