Tempo de leitura: 4 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post.
A Liquid AI anunciou dois modelos abertos da família d1 voltados para decisões rápidas em dispositivos de borda: o d1-3B e o experimental d1-omni-600M. A proposta é diferente da de um modelo generativo tradicional: em vez de produzir uma sequência de tokens, esses modelos respondem em uma única passagem pela rede.
Essa mudança pode parecer discreta, mas ajuda a explicar por que a empresa está mirando robótica, sensores, dispositivos embarcados e outras aplicações em que alguns milissegundos fazem diferença. O detalhe mais interessante está na combinação entre entradas multimodais, pesos abertos e execução local.
Como funcionam os modelos d1 multimodais
Segundo a Liquid AI, o d1-3B foi desenvolvido a partir do modelo visual-linguístico LFM2.5-VL-3B, com suporte a texto e imagens. Já o d1-omni-600M usa como base o LFM2.5-Encoder-350M e acrescenta codificadores de visão e áudio.
Na prática, o d1-omni-600M pode receber texto e imagem ou texto e áudio. A empresa classifica essa versão como um lançamento inicial de pesquisa, que ainda está em desenvolvimento. Isso significa que os resultados são promissores, mas não devem ser interpretados como uma validação definitiva para qualquer cenário de produção.
Desempenho dos modelos d1 multimodais em avaliações
Nos testes apresentados pela Liquid AI, os modelos foram avaliados em sete conjuntos de dados públicos relacionados a compreensão de leitura, detecção de toxicidade, classificação de intenções, perguntas e respostas médicas e compreensão multilíngue.
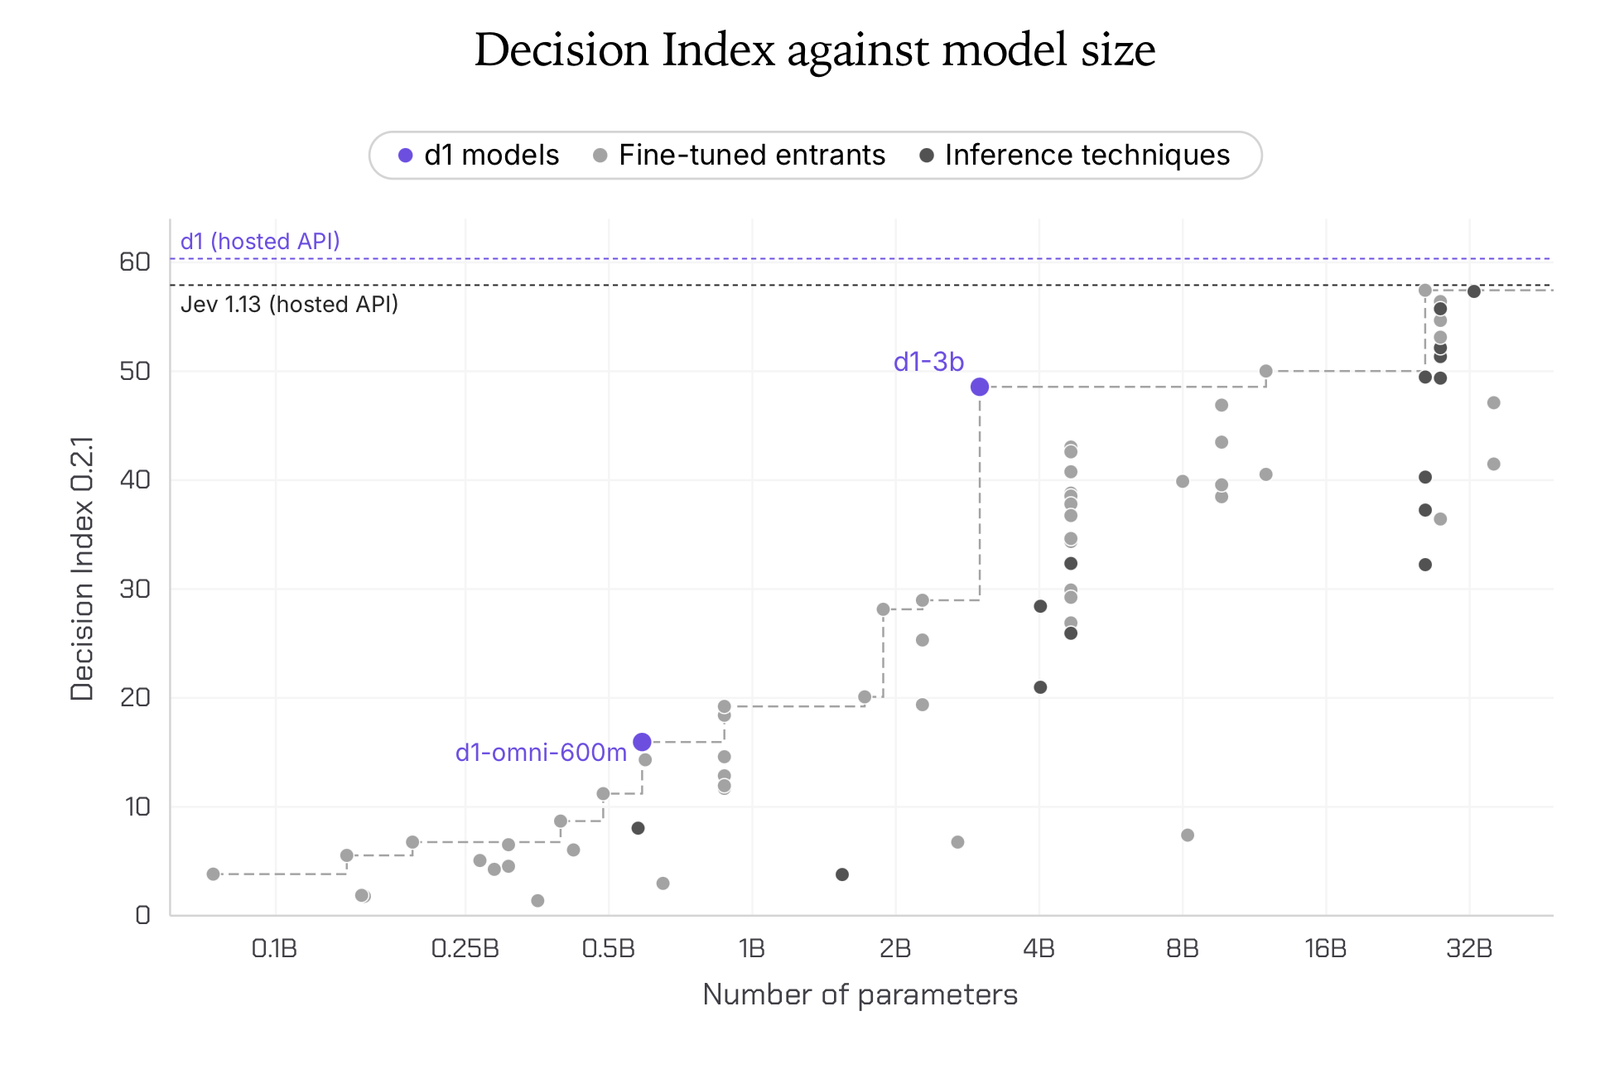
O d1-3B obteve média de 82,9, enquanto o d1-omni-600M alcançou 78,4. De acordo com a empresa, o d1-3B ficou acima dos modelos Decider 2B e Decider 4B na média geral. O modelo menor também superou o Decider 2B, apesar de ter um quarto do número de parâmetros.
Há uma ressalva importante: a própria Liquid AI informa que não apresentou benchmarks de visão ou áudio específicos para esses modelos. O Decision Index utilizado não inclui, segundo a publicação, uma divisão pública de visão, e os benchmarks de decisão em áudio ainda são considerados um problema em aberto.
Velocidade dos modelos d1 multimodais na borda
O foco na inferência local aparece com mais clareza nos números de latência. Nos testes divulgados, o d1-3B respondeu a uma pergunta em 16 milissegundos no NVIDIA Jetson AGX Thor, 26 milissegundos no Jetson AGX Orin e 50 milissegundos no Jetson Orin Nano.
Em uma NVIDIA RTX 4090, a resposta levou 8 milissegundos, enquanto uma imagem de 384 pixels foi processada em 17 milissegundos. A Liquid AI também mediu o modelo em um AMD MI325X, onde registrou 9 milissegundos para uma pergunta.
Esses números não significam que qualquer aplicação terá o mesmo desempenho. Hardware, tamanho do estado mantido, resolução das imagens e implementação podem alterar bastante o resultado. Ainda assim, eles mostram por que modelos de decisão de menor porte podem ser úteis quando enviar cada entrada para um servidor remoto não é desejável ou viável.
Para que servem os modelos d1 multimodais
A Liquid AI recomenda a família d1 para tarefas que exigem decisões estruturadas e rápidas, inclusive quando os dados chegam em mais de uma modalidade. Um dispositivo poderia, por exemplo, combinar uma instrução textual com uma imagem ou um sinal de áudio para classificar uma situação.
O d1-3B prioriza a qualidade das decisões dentro da sua faixa de tamanho, enquanto o d1-omni-600M atende a cenários em que o espaço ocupado pelo modelo é uma preocupação central. Essa diferença é relevante em equipamentos de borda, nos quais memória, consumo de energia e conectividade costumam ser limitados.
Os dois modelos têm pesos abertos e estão disponíveis no Hugging Face. A empresa também publicou uma demonstração no System One Arcade. Para quem quiser testar a implementação, as instruções do d1-3B estão na página do modelo no Hugging Face, enquanto o d1-omni-600M possui um model card próprio.
O que o lançamento dos modelos d1 multimodais indica
O lançamento reforça uma tendência importante: nem toda aplicação de IA precisa de um modelo generativo grande produzindo textos longos. Em muitos casos, o que importa é classificar, selecionar, detectar ou tomar uma decisão com baixa latência.
Essa abordagem pode reduzir o custo e a dependência de serviços remotos, mas também exige cuidado. Um modelo que responde rapidamente ainda precisa ser avaliado no contexto real, especialmente quando suas decisões afetam pessoas, equipamentos ou processos críticos. Velocidade é uma vantagem; não é sinônimo de confiabilidade.
Por enquanto, os modelos d1 multimodais parecem mais interessantes como uma base aberta para experimentação e aplicações de borda do que como uma solução universal. O d1-3B já apresenta resultados competitivos nos testes divulgados, enquanto o d1-omni-600M oferece uma alternativa compacta, embora ainda esteja em fase experimental.