Generic selectors
Exact matches only
Search in title
Search in content
Post Type Selectors

Modelos densos vs. MoE: parâmetros ativos, desempenho e quando escolher cada um

Modelos densos vs. MoE: parâmetros ativos, desempenho e quando escolher cada um
Modelos densos ativam todos os parâmetros a cada token, enquanto arquiteturas MoE selecionam apenas alguns especialistas. Entenda os ganhos, custos e critérios para escolher entre elas.

Índice

Tempo de leitura: 6 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Escolher um modelo de inteligência artificial pelo número total de parâmetros parece simples, mas essa comparação pode esconder uma diferença decisiva: nem todo modelo usa todos os seus parâmetros a cada token. Em um artigo publicado em 15 de setembro de 2026, a NVIDIA explica como arquiteturas densas e Mixture-of-Experts (MoE) mudam o equilíbrio entre capacidade, memória, velocidade e complexidade de implantação.

A pergunta central é curiosa: como um modelo com 30 bilhões de parâmetros pode ativar apenas 3 bilhões por token e ainda aproveitar a capacidade de uma rede muito maior? A resposta está na maneira como os parâmetros são organizados e selecionados durante a inferência.

Como funcionam os modelos densos vs. MoE

Em um modelo denso, todos os parâmetros participam do processamento de cada token. Se o modelo tem 27 bilhões de parâmetros, os 27 bilhões são usados em cada passagem pela rede, incluindo o bloco feed-forward presente nas camadas do decodificador.

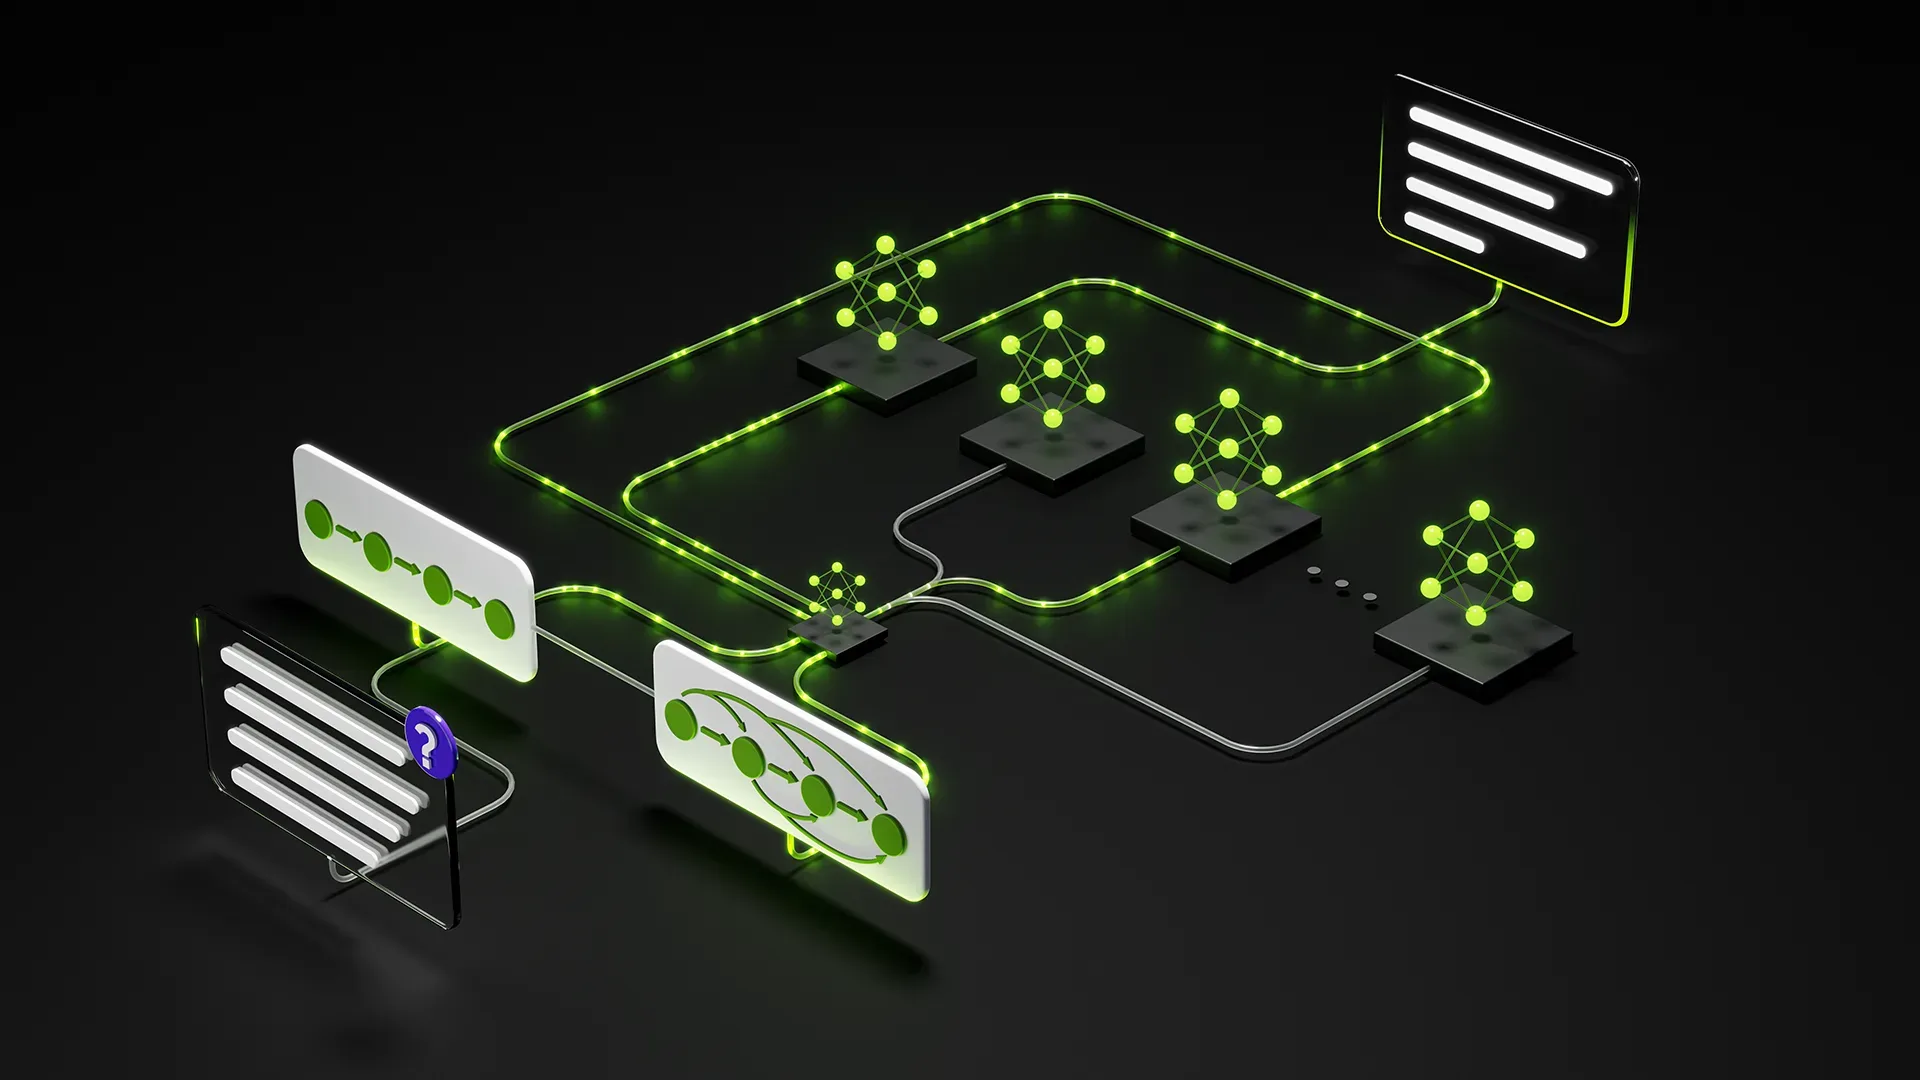
Já um modelo MoE mantém vários blocos feed-forward, chamados de especialistas, mas utiliza apenas uma parte deles para cada token. Um mecanismo conhecido como roteador escolhe os especialistas mais adequados em cada camada. Assim, os demais blocos permanecem armazenados na memória, mas não são executados naquele momento.

Essa escolha não acontece uma única vez para toda a frase. O token pode ser encaminhado para especialistas diferentes em cada camada, conforme a representação que a rede constrói durante o processamento. Os especialistas também não são necessariamente “especialistas” em assuntos como matemática ou história; suas diferenças podem estar mais relacionadas a padrões de sintaxe, pontuação e tipos de token.

É importante não confundir parâmetros ativos com parâmetros totais. Quando um modelo MoE informa que possui 3 bilhões de parâmetros ativos, esse número representa o conjunto usado para cada token, incluindo componentes como atenção, embeddings e os especialistas selecionados. O restante continua sendo necessário para armazenar o modelo completo.

Por que os modelos densos vs. MoE apresentam desempenhos diferentes

A principal vantagem do MoE é separar duas despesas que crescem juntas em um modelo denso: memória e computação por token. Todos os especialistas precisam estar disponíveis na memória, mas apenas uma fração deles é executada a cada passo.

Na prática, isso pode aumentar o throughput, ou seja, a quantidade de tokens processados por segundo. A NVIDIA compara modelos de porte semelhante e cita o Nemotron 3.5 Lightning, com 30 bilhões de parâmetros totais e 3 bilhões ativos, como exemplo de arquitetura capaz de alcançar maior velocidade de geração do que modelos densos de tamanho parecido.

Esse resultado não depende apenas do MoE. O Nemotron 3.5 Lightning também combina a arquitetura com camadas Mamba-2 e decodificação especulativa, fatores que influenciam o desempenho de forma independente. Por isso, benchmarks não devem ser interpretados como uma prova de que qualquer MoE será automaticamente mais rápido do que qualquer modelo denso.

Em baixa concorrência, a redução de parâmetros lidos por token pode ser especialmente útil. Conforme mais solicitações são processadas ao mesmo tempo, diferentes tokens passam a utilizar uma parcela maior dos especialistas. O ganho de latência pode diminuir, embora o MoE ainda possa manter vantagem de throughput.

Existe também um custo menos visível: como todos os especialistas precisam permanecer carregados, sobra menos memória para componentes como o cache KV. Em outras palavras, o modelo MoE troca parte da simplicidade de execução por uma utilização mais seletiva da computação.

Quando escolher modelos densos vs. MoE

A escolha entre modelos densos vs. MoE deve partir do cenário de implantação, e não apenas do número estampado na página do modelo. Um modelo MoE de 30 bilhões de parâmetros e um modelo denso de porte semelhante podem exigir uma quantidade comparável de memória para serem carregados. A diferença é o que essa memória compra: no modelo denso, mais computação por token; no MoE, potencialmente mais throughput.

Memória e concorrência

Se a aplicação precisa atender muitas solicitações e o objetivo principal é processar grandes volumes de tokens, o MoE pode ser uma escolha interessante. Ainda assim, a decisão deve ser validada no hardware e no framework reais, porque movimentação de memória, precisão numérica, balanceamento dos especialistas e implementação do roteador alteram o resultado.

Para aplicações sensíveis à latência sob alta concorrência, um modelo denso bem otimizado pode ser mais previsível. Ele não precisa distribuir tokens entre especialistas nem lidar com o mesmo nível de complexidade de comunicação e armazenamento.

Ajuste fino e quantização

O ajuste fino de modelos densos costuma ser mais direto, já que todos os parâmetros participam do treinamento. Em um MoE, o roteador pode ficar desequilibrado: alguns especialistas recebem tokens demais enquanto outros são pouco utilizados. Técnicas como LoRA, PEFT ou o congelamento do roteador podem ajudar, mas exigem uma estratégia compatível com o modelo.

A quantização também merece atenção. Não basta presumir que reduzir a precisão sempre produzirá a mesma economia em qualquer arquitetura. Em modelos MoE, pequenas alterações no roteador podem mudar a seleção discreta dos especialistas. Em arquiteturas híbridas, projeções recorrentes e outros componentes também podem exigir precisão maior.

Para quem acompanha otimizações de inferência, o caso é semelhante ao discutido em otimizações de serving para modelos Nemotron: o desempenho final depende da combinação entre modelo, software, hardware e carga de trabalho, e não de uma única característica isolada.

O principal trade-off dos modelos densos vs. MoE

Modelos densos e MoE respondem a prioridades diferentes. O modelo denso mantém todos os parâmetros ativos, o que facilita compreender, ajustar e servir a rede. O MoE usa memória para armazenar uma capacidade maior e computação seletiva para tentar reduzir o custo de cada token.

Isso não transforma o MoE em uma solução universal. Se a equipe tem pouca memória disponível, precisa de uma implantação simples ou pretende fazer um ajuste fino completo com o mínimo de riscos, um modelo denso pode ser mais adequado. Se o ambiente comporta a memória adicional e precisa de alto volume de inferência, a arquitetura MoE pode oferecer uma relação mais atraente entre capacidade e throughput.

O ponto central é abandonar a comparação baseada apenas em parâmetros totais. Antes de escolher, vale medir memória disponível, concorrência, latência, custo por token, comportamento da quantização e dificuldade de treinamento. É nessa combinação que a diferença entre modelos densos vs. MoE deixa de ser um detalhe arquitetural e se transforma em uma decisão prática de infraestrutura.

Fontes

RECENTES

Radisson leva descoberta de hotéis para o ChatGPT
O Radisson levou a descoberta de hotéis para o ChatGPT com mapas, preços e comparação de comodidades. Os primeiros resultados indicam conversão 1,5 vez maior que a busca orgânica.
OpenAI amplia o ChatGPT para adolescentes com planejamento universitário e novas ferramentas de estudo
A OpenAI anunciou um planejador universitário, flashcards, quizzes e um conselho de jovens para ampliar o ChatGPT para adolescentes.

LEIS MAIS


CONTINUE NO PLANKSNET

NVIDIA usa gêmeos digitais para validar mudanças em fábricas de IA
8 min de leitura
A NVIDIA apresentou uma abordagem que combina o DSX Air, o Brev e agentes de IA para testar configurações e integrações de fábricas de IA antes da implantação física.
NVIDIA cuOpt mPDLP leva a otimização linear a mais de 100 milhões de variáveis
5 min de leitura
A NVIDIA apresentou o cuOpt mPDLP, método multi-GPU que distribui problemas de programação linear com mais de 100 milhões de variáveis e reduz a pressão sobre memória e tempo de processamento.

VEJA TAMBÉM

Modelos densos vs. MoE: parâmetros ativos, desempenho e quando escolher cada um

Modelos densos vs. MoE: parâmetros ativos, desempenho e quando escolher cada um
Modelos densos ativam todos os parâmetros a cada token, enquanto arquiteturas MoE selecionam apenas alguns especialistas. Entenda os ganhos, custos e critérios para escolher entre elas.

Índice

Tempo de leitura: 6 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Escolher um modelo de inteligência artificial pelo número total de parâmetros parece simples, mas essa comparação pode esconder uma diferença decisiva: nem todo modelo usa todos os seus parâmetros a cada token. Em um artigo publicado em 15 de setembro de 2026, a NVIDIA explica como arquiteturas densas e Mixture-of-Experts (MoE) mudam o equilíbrio entre capacidade, memória, velocidade e complexidade de implantação.

A pergunta central é curiosa: como um modelo com 30 bilhões de parâmetros pode ativar apenas 3 bilhões por token e ainda aproveitar a capacidade de uma rede muito maior? A resposta está na maneira como os parâmetros são organizados e selecionados durante a inferência.

Como funcionam os modelos densos vs. MoE

Em um modelo denso, todos os parâmetros participam do processamento de cada token. Se o modelo tem 27 bilhões de parâmetros, os 27 bilhões são usados em cada passagem pela rede, incluindo o bloco feed-forward presente nas camadas do decodificador.

Já um modelo MoE mantém vários blocos feed-forward, chamados de especialistas, mas utiliza apenas uma parte deles para cada token. Um mecanismo conhecido como roteador escolhe os especialistas mais adequados em cada camada. Assim, os demais blocos permanecem armazenados na memória, mas não são executados naquele momento.

Essa escolha não acontece uma única vez para toda a frase. O token pode ser encaminhado para especialistas diferentes em cada camada, conforme a representação que a rede constrói durante o processamento. Os especialistas também não são necessariamente “especialistas” em assuntos como matemática ou história; suas diferenças podem estar mais relacionadas a padrões de sintaxe, pontuação e tipos de token.

É importante não confundir parâmetros ativos com parâmetros totais. Quando um modelo MoE informa que possui 3 bilhões de parâmetros ativos, esse número representa o conjunto usado para cada token, incluindo componentes como atenção, embeddings e os especialistas selecionados. O restante continua sendo necessário para armazenar o modelo completo.

Por que os modelos densos vs. MoE apresentam desempenhos diferentes

A principal vantagem do MoE é separar duas despesas que crescem juntas em um modelo denso: memória e computação por token. Todos os especialistas precisam estar disponíveis na memória, mas apenas uma fração deles é executada a cada passo.

Na prática, isso pode aumentar o throughput, ou seja, a quantidade de tokens processados por segundo. A NVIDIA compara modelos de porte semelhante e cita o Nemotron 3.5 Lightning, com 30 bilhões de parâmetros totais e 3 bilhões ativos, como exemplo de arquitetura capaz de alcançar maior velocidade de geração do que modelos densos de tamanho parecido.

Esse resultado não depende apenas do MoE. O Nemotron 3.5 Lightning também combina a arquitetura com camadas Mamba-2 e decodificação especulativa, fatores que influenciam o desempenho de forma independente. Por isso, benchmarks não devem ser interpretados como uma prova de que qualquer MoE será automaticamente mais rápido do que qualquer modelo denso.

Em baixa concorrência, a redução de parâmetros lidos por token pode ser especialmente útil. Conforme mais solicitações são processadas ao mesmo tempo, diferentes tokens passam a utilizar uma parcela maior dos especialistas. O ganho de latência pode diminuir, embora o MoE ainda possa manter vantagem de throughput.

Existe também um custo menos visível: como todos os especialistas precisam permanecer carregados, sobra menos memória para componentes como o cache KV. Em outras palavras, o modelo MoE troca parte da simplicidade de execução por uma utilização mais seletiva da computação.

Quando escolher modelos densos vs. MoE

A escolha entre modelos densos vs. MoE deve partir do cenário de implantação, e não apenas do número estampado na página do modelo. Um modelo MoE de 30 bilhões de parâmetros e um modelo denso de porte semelhante podem exigir uma quantidade comparável de memória para serem carregados. A diferença é o que essa memória compra: no modelo denso, mais computação por token; no MoE, potencialmente mais throughput.

Memória e concorrência

Se a aplicação precisa atender muitas solicitações e o objetivo principal é processar grandes volumes de tokens, o MoE pode ser uma escolha interessante. Ainda assim, a decisão deve ser validada no hardware e no framework reais, porque movimentação de memória, precisão numérica, balanceamento dos especialistas e implementação do roteador alteram o resultado.

Para aplicações sensíveis à latência sob alta concorrência, um modelo denso bem otimizado pode ser mais previsível. Ele não precisa distribuir tokens entre especialistas nem lidar com o mesmo nível de complexidade de comunicação e armazenamento.

Ajuste fino e quantização

O ajuste fino de modelos densos costuma ser mais direto, já que todos os parâmetros participam do treinamento. Em um MoE, o roteador pode ficar desequilibrado: alguns especialistas recebem tokens demais enquanto outros são pouco utilizados. Técnicas como LoRA, PEFT ou o congelamento do roteador podem ajudar, mas exigem uma estratégia compatível com o modelo.

A quantização também merece atenção. Não basta presumir que reduzir a precisão sempre produzirá a mesma economia em qualquer arquitetura. Em modelos MoE, pequenas alterações no roteador podem mudar a seleção discreta dos especialistas. Em arquiteturas híbridas, projeções recorrentes e outros componentes também podem exigir precisão maior.

Para quem acompanha otimizações de inferência, o caso é semelhante ao discutido em otimizações de serving para modelos Nemotron: o desempenho final depende da combinação entre modelo, software, hardware e carga de trabalho, e não de uma única característica isolada.

O principal trade-off dos modelos densos vs. MoE

Modelos densos e MoE respondem a prioridades diferentes. O modelo denso mantém todos os parâmetros ativos, o que facilita compreender, ajustar e servir a rede. O MoE usa memória para armazenar uma capacidade maior e computação seletiva para tentar reduzir o custo de cada token.

Isso não transforma o MoE em uma solução universal. Se a equipe tem pouca memória disponível, precisa de uma implantação simples ou pretende fazer um ajuste fino completo com o mínimo de riscos, um modelo denso pode ser mais adequado. Se o ambiente comporta a memória adicional e precisa de alto volume de inferência, a arquitetura MoE pode oferecer uma relação mais atraente entre capacidade e throughput.

O ponto central é abandonar a comparação baseada apenas em parâmetros totais. Antes de escolher, vale medir memória disponível, concorrência, latência, custo por token, comportamento da quantização e dificuldade de treinamento. É nessa combinação que a diferença entre modelos densos vs. MoE deixa de ser um detalhe arquitetural e se transforma em uma decisão prática de infraestrutura.

Fontes

Modelos densos vs. MoE: parâmetros ativos, desempenho e quando escolher cada um

VEJA TAMBÉM