Tempo de leitura: 6 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post.
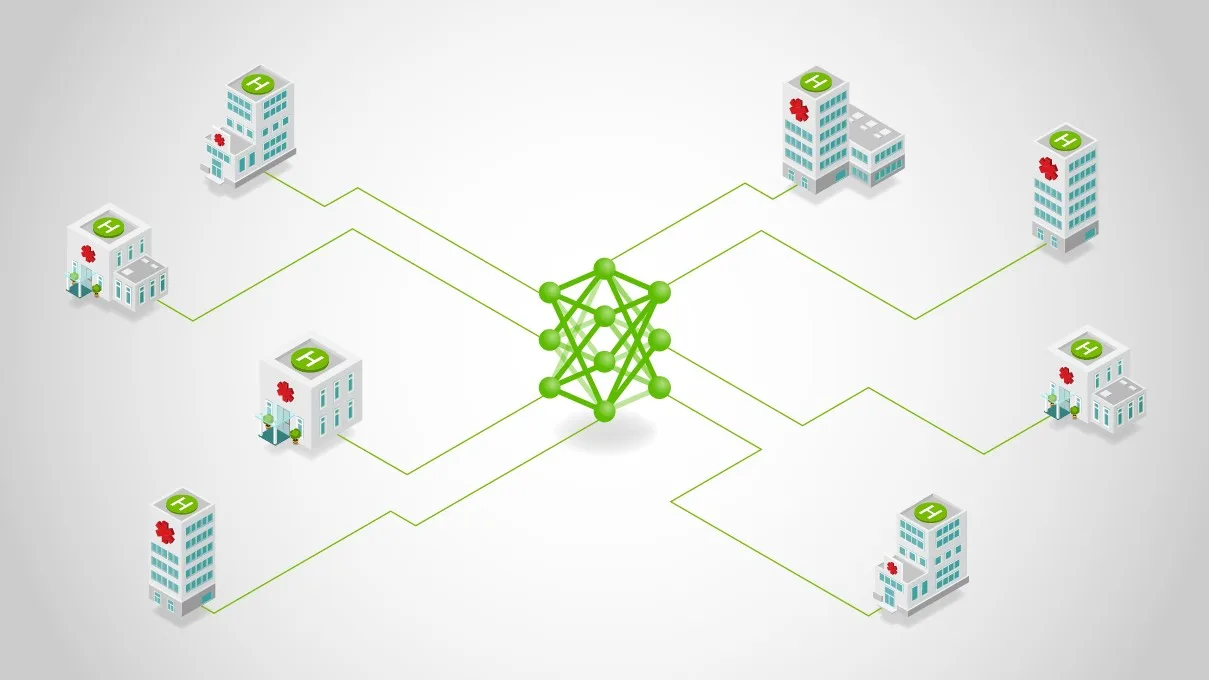
Projetos de aprendizado federado costumam começar de maneira simples: um servidor, alguns clientes e um conjunto de dados em cada local. O problema aparece quando a colaboração cresce e cada organização utiliza uma infraestrutura diferente. Um hospital pode trabalhar com Docker, outro pode usar Kubernetes, enquanto uma universidade mantém seus GPUs em um cluster administrado pelo Slurm.
Em uma atualização publicada em 15 de setembro de 2026, a NVIDIA apresentou como o NVIDIA FLARE pode coordenar esse tipo de federação heterogênea. A ideia central é separar os serviços permanentes da federação dos trabalhadores temporários que executam cada tarefa. Parece uma mudança de arquitetura, mas ela resolve uma dificuldade bastante prática: permitir que cada participante mantenha o controle sobre seus dados, recursos e políticas locais sem obrigar todos a adotar a mesma plataforma.
Como o NVIDIA FLARE separa a federação da execução dos trabalhos
O NVIDIA FLARE passa a operar em duas camadas. Processos pai, que permanecem ativos, mantêm a federação, autenticam as conexões e coordenam o trabalho. Quando um estudo é submetido, esses processos iniciam trabalhadores específicos para aquela tarefa.
Esses trabalhadores usam os recursos apenas enquanto o trabalho está em execução. Depois de receber os dados necessários, concluir sua parte e devolver os resultados, eles são encerrados. Assim, os processos responsáveis pela coordenação continuam disponíveis sem ocupar permanentemente os GPUs usados no treinamento.
Essa separação também permite descrever a necessidade de recursos de forma independente da plataforma. Um trabalho pode solicitar GPUs, unidades de CPU e memória, enquanto o ambiente de cada participante traduz esses requisitos para sua própria infraestrutura.
O que muda com Docker, Kubernetes e Slurm no NVIDIA FLARE
O ponto mais importante é que os participantes da mesma federação não precisam usar o mesmo ambiente de execução. O Docker pode iniciar um contêiner em um servidor local, o Kubernetes pode criar um pod em um cluster e o Slurm pode reservar uma alocação em um ambiente de computação de alto desempenho.
No modelo descrito pela NVIDIA, o servidor persistente pode estar em um cluster Kubernetes, enquanto um hospital executa seu trabalhador em um contêiner Docker, outro hospital usa um pod Kubernetes e uma universidade utiliza uma alocação Slurm. Todos continuam participando do mesmo fluxo federado, mas cada site preserva sua autoridade sobre os recursos locais.
Docker para ambientes de host único
Em uma estação de trabalho, servidor de laboratório ou sistema de borda, o Docker pode ser usado para manter o processo pai e iniciar um contêiner separado para cada trabalho. A imagem principal contém o ambiente necessário para o NVIDIA FLARE, enquanto a imagem do trabalho pode reunir o framework de treinamento, o código do modelo e suas dependências.
Essa separação facilita atualizações independentes. Os responsáveis pela infraestrutura podem manter o ambiente principal estável, enquanto pesquisadores atualizam seus ambientes de treinamento dentro das regras de aprovação de imagens e código definidas pelo site.
Kubernetes para pods criados sob demanda
No Kubernetes, os processos persistentes são instalados como pods e criam pods de trabalho quando uma tarefa é enviada. O agendador pode posicionar esses pods conforme requisitos de CPU, memória, GPU, armazenamento e localização.
O ambiente também pode aproveitar namespaces, contas de serviço, Secrets, volumes persistentes, políticas de admissão, seletores de nós e controles de acesso baseados em funções. Na prática, um estudo pode ser direcionado a um grupo específico de máquinas, enquanto outro utiliza uma configuração diferente, sem misturar os recursos de ambos.
Slurm para clusters de pesquisa e GPUs
O suporte ao Slurm é a novidade associada à versão 2.9 do NVIDIA FLARE. Nesse cenário, cada trabalhador é enviado como um trabalho em lote. O Slurm decide quais nós serão utilizados e aplica limites relacionados a GPUs, CPUs, memória, partições, contas, qualidade de serviço e tempo de execução.
A abordagem mantém o Slurm como autoridade sobre os recursos do cluster. Administradores continuam usando contas, partições, políticas de qualidade de serviço, permissões do sistema de arquivos e controles de dispositivos que já fazem parte da operação normal do ambiente.
Como o NVIDIA FLARE separa estudos, dados e segredos
Usar uma infraestrutura compartilhada cria outra preocupação: impedir que diferentes experimentos misturem usuários, trabalhos ou dados. Para isso, o NVIDIA FLARE utiliza estudos como limites lógicos de separação dentro de uma mesma implantação.
Cada estudo define os sites participantes e os administradores autorizados a abrir uma sessão. A partir dessa sessão, a visibilidade dos trabalhos, o status dos clientes, os destinos de envio e o mapa de implantação ficam associados ao estudo ativo.
A separação continua no ambiente de cada participante. Um arquivo de configuração local pode associar o estudo a conjuntos de dados, imagens aprovadas, variáveis de ambiente, segredos e políticas de execução. O pesquisador escolhe o estudo, mas não seleciona livremente caminhos locais de dados nem fornece valores secretos diretamente.
Em um exemplo de estudo de patologia, a configuração do site pode apontar para um volume de dados e para credenciais armazenadas em um mecanismo de Secrets do Kubernetes. O trabalhador recebe as referências necessárias quando é criado, enquanto os valores das credenciais permanecem sob controle da organização responsável pelo ambiente.
Como os trabalhos são enviados pelo NVIDIA FLARE
O NVIDIA FLARE 2.9 permite declarar requisitos portáteis de GPU, CPU e memória no arquivo de metadados do trabalho. Esses requisitos podem ser aplicados a todos os participantes por meio de um perfil padrão, com exceções definidas para um cliente ou para o servidor.
Depois, cada lançador converte os mesmos requisitos para sua plataforma. No Docker, isso pode significar configurar limites de CPU, memória e dispositivos GPU. No Kubernetes, os valores são transformados em solicitações e limites de recursos do pod. No Slurm, eles correspondem a parâmetros de CPU, memória e GPU da alocação.
O pesquisador envia o trabalho uma vez a partir de uma sessão associada ao estudo. O servidor valida a participação e coordena o fluxo, enquanto os lançadores locais combinam os requisitos portáteis com as configurações aprovadas por cada site.
Por que o NVIDIA FLARE pode facilitar federações maiores
A principal consequência é que a heterogeneidade deixa de ser necessariamente um bloqueio. Uma federação pode reunir organizações que operam em nuvens, servidores locais e clusters de pesquisa sem transformar a padronização da infraestrutura em uma condição para a colaboração.
Isso não elimina a necessidade de governança. Cada site ainda precisa aprovar imagens, proteger segredos, configurar permissões e validar o isolamento dos trabalhos. A diferença é que essas decisões permanecem sob responsabilidade local, enquanto o NVIDIA FLARE cuida da autenticação, da comunicação segura, da autorização e da coordenação federada.
Também existe um limite importante: estudos são adequados quando as organizações compartilham a mesma implantação e a mesma infraestrutura de chaves públicas. Quando são necessários administradores de infraestrutura separados, uma PKI própria ou um limite diferente para o impacto de falhas, a recomendação apresentada é utilizar implantações distintas.
Em resumo, a atualização anunciada pela NVIDIA trata o aprendizado federado menos como um programa isolado e mais como uma operação distribuída. O NVIDIA FLARE 2.9 acrescenta o Slurm às opções de execução, enquanto Docker e Kubernetes continuam atendendo outros perfis de ambiente. Com essa arquitetura, os serviços de coordenação permanecem estáveis e os recursos de treinamento são criados apenas quando necessários.
O resultado é uma federação mais flexível, mas não necessariamente mais simples: a tecnologia resolve a conexão entre ambientes diferentes, enquanto as organizações continuam responsáveis por decidir quais dados, imagens, segredos e recursos cada estudo pode acessar. Para conhecer os detalhes técnicos, a NVIDIA disponibiliza a documentação do NVIDIA FLARE e o repositório oficial no GitHub.