Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Servir modelos generativos em uma única GPU pode funcionar bem até o momento em que o modelo cresce, as sequências ficam mais longas e cada segundo de espera começa a pesar. A NVIDIA apresentou uma integração que tenta tornar esse cenário menos complicado: a inferência multi-GPU com TensorRT dentro do Dynamo-Triton.
A proposta é permitir que uma única instância de modelo utilize várias GPUs de forma distribuída, enquanto a aplicação continua chamando apenas um endpoint gRPC. Em vez de o cliente controlar os diferentes processos, ranks e comunicadores, essa responsabilidade fica no servidor. Parece uma mudança de bastidores, mas é justamente aí que a solução pode ser útil para equipes que precisam reduzir a latência sem reconstruir toda a aplicação.
O resultado mais chamativo aparece em um teste de geração de vídeo com o NVIDIA Cosmos 3 Nano. Porém, antes de olhar para os números, é importante entender o que muda na arquitetura — e também o que esse benchmark ainda não mede.
Como funciona a inferência multi-GPU no Dynamo-Triton
A capacidade de inferência multi-GPU usa um único plano TensorRT distribuído entre várias GPUs. A comunicação entre os dispositivos é realizada por operações coletivas apoiadas pelo NCCL, enquanto o TensorRT mantém suas otimizações de execução.
De acordo com a NVIDIA, o suporte passou a ser integrado ao backend TensorRT do Dynamo-Triton na versão 26.07. Uma instância configurada como KIND_MODEL pode assumir várias GPUs, criar os contextos de execução, streams CUDA e comunicadores NCCL correspondentes a cada rank e iniciar a execução distribuída para cada solicitação.
Para a aplicação, a mudança é mais simples: ela continua enviando uma requisição para um modelo identificado por nome. O cliente não precisa coordenar diretamente os ranks participantes. É como trocar vários operadores tentando sincronizar uma máquina por um painel único que esconde a complexidade do motor.
Inferência multi-GPU com TensorRT e o exemplo do Cosmos 3 Nano
A demonstração utiliza o Cosmos 3 Nano para gerar vídeos. Nesse fluxo, o Diffusers continua responsável por etapas como preparação dos prompts, latentes, orientação sem classificador, agendamento, decodificação pelo VAE e pós-processamento dos quadros.
O Dynamo-Triton fica encarregado do transformador de denoising com 36 camadas. A inferência multi-GPU distribui os 44.160 tokens de vídeo usando o paralelismo de contexto Ulysses, que pode operar com até oito GPUs. A parte textual, com 2.992 tokens, permanece replicada entre os ranks.
Essa divisão foi escolhida porque o transformador representa a maior parte do tempo de geração. No teste de uma GPU, as chamadas RPC relacionadas ao transformador respondiam por 93,4% do tempo total. Como cada uma das 35 etapas de denoising exige duas previsões para a orientação sem classificador, o fluxo realiza 70 chamadas ao Triton durante uma geração completa.
O papel do paralelismo de contexto na inferência multi-GPU
O Ulysses altera a distribuição dos dados ao redor da atenção. Cada rank processa uma parte não sobreposta das cabeças de atenção, enquanto operações como reduce-scatter, all-to-all e all-gather permitem trocar as informações necessárias entre as GPUs.
O gráfico distribuído é compilado previamente em cada plano TensorRT. Isso significa que o Dynamo-Triton não transforma, durante a execução, um mecanismo de uma GPU em um mecanismo distribuído. O plano já precisa ter sido preparado para o contexto paralelo, e a configuração do servidor apenas ativa o caminho correspondente.
O que os resultados mostram sobre a inferência multi-GPU
O benchmark comparou uma configuração de uma GPU com versões de paralelismo de contexto usando duas, quatro e oito GPUs. Todas utilizaram a mesma configuração de vídeo: resolução de 1280 por 720, 189 quadros a 24 FPS e 35 etapas de denoising. Cada resultado teve uma execução de aquecimento e cinco gerações completas medidas.
Na configuração de uma GPU, a latência média de ponta a ponta foi de 156,595 segundos. Com duas GPUs, caiu para 87,999 segundos; com quatro, para 53,093 segundos; e com oito GPUs, para 34,183 segundos.
Isso representa uma redução de aproximadamente 78,17% no tempo total entre uma e oito GPUs. O tempo das chamadas RPC do transformador caiu de 146,192 para 23,993 segundos, com aceleração de 6,09 vezes. A melhoria, portanto, é expressiva, mas não perfeitamente linear.
A razão está no trabalho que não desaparece quando mais GPUs são adicionadas. Preparação do prompt, atualizações do agendador, decodificação do VAE, pós-processamento e outras etapas do cliente permaneceram entre 10,2 e 10,5 segundos nas configurações avaliadas. À medida que o transformador fica mais rápido, essas etapas ocupam uma fatia maior do tempo final.
Inferência multi-GPU não significa apenas adicionar GPUs
O teste também mostra por que números de aceleração precisam ser lidos com cuidado. O ganho foi medido em latência de uma geração completa, não em throughput com várias solicitações simultâneas, custo por vídeo ou custo total de propriedade.
Usar oito GPUs para atender uma solicitação pode ser uma escolha interessante quando o tempo de resposta tem alto valor, como em fluxos de mídia generativa nos quais alguém precisa gerar, revisar e ajustar resultados rapidamente. Em outros cenários, a prioridade pode ser atender mais usuários simultaneamente com menor custo por solicitação.
Essa é a principal troca envolvida: mais recursos computacionais em troca de menor latência. A melhor configuração dependerá das metas de serviço, do orçamento e do perfil de tráfego. Um benchmark rápido não elimina a necessidade de testar concorrência, disponibilidade, consumo e comportamento em produção.
Validação visual dos resultados
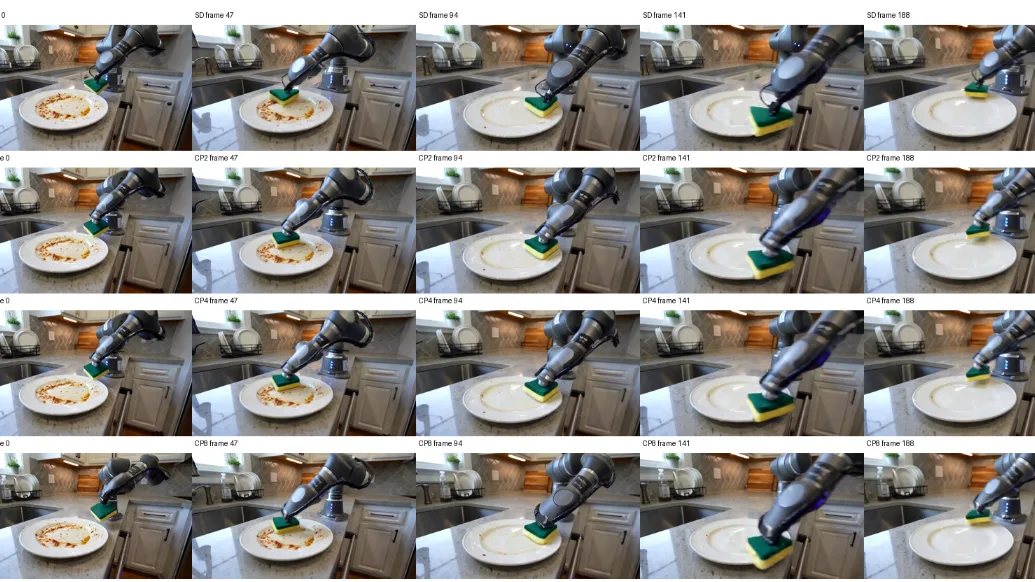
A NVIDIA informa que as variantes foram executadas com a mesma semente e o mesmo perfil de geração. Foram avaliados os quadros 0, 47, 94, 141 e 188, além de critérios de formato, variação temporal e comparação com a saída de uma GPU.
As configurações CP2, CP4 e CP8 passaram pelos limites definidos de erro médio absoluto de até 25 e PSNR de pelo menos 18 dB. A configuração de oito GPUs apresentou MAE de 16,316 e PSNR de 19,400 dB. Isso não significa que os vídeos sejam pixel a pixel idênticos, mas indica que, dentro dos critérios usados no teste, a saída manteve coerência visual.
Como começar a testar a inferência multi-GPU
Para reproduzir o cenário apresentado, a NVIDIA orienta o uso do Dynamo-Triton 26.07, junto com os recursos do TensorRT, Torch-TensorRT, Diffusers e Cosmos. A configuração do modelo deve apontar para um plano TensorRT que já contenha o gráfico distribuído e habilitar o caminho multi-device no backend.
Um exemplo de configuração utiliza a opção enable_multi_device e identifica as GPUs participantes, como os dispositivos de 0 a 7 em uma configuração CP8. A documentação oficial do backend TensorRT multi-device do Triton detalha os parâmetros necessários, enquanto a documentação do TensorRT Multi-Device explica as APIs e o funcionamento da execução distribuída.
Na prática, equipes devem começar reproduzindo o caso em um ambiente controlado e depois medir suas próprias cargas. A latência apresentada pela NVIDIA é específica do Cosmos 3 Nano, da configuração de vídeo e do sistema utilizado no benchmark.
O que a inferência multi-GPU muda para quem implanta modelos
A integração reduz uma parte importante da complexidade operacional. A aplicação não precisa conhecer a topologia completa das GPUs nem administrar diretamente o ciclo de vida dos comunicadores distribuídos. O modelo pode ser empacotado como uma versão no repositório do Triton e exposto por uma interface de serviço convencional.
Isso não transforma a distribuição em um detalhe irrelevante. Ainda é necessário compilar o plano correto, reservar GPUs compatíveis, avaliar a comunicação entre dispositivos e validar se a qualidade das saídas atende ao caso de uso. Mas a fronteira entre a aplicação e a infraestrutura fica mais limpa, o que pode facilitar a adoção em serviços de inferência generativa.
Em outras palavras, a NVIDIA não está prometendo que oito GPUs sempre serão oito vezes mais rápidas. O que a integração oferece é uma forma mais organizada de usar várias GPUs quando um modelo ou uma sequência ultrapassa o que uma única placa consegue entregar dentro do tempo desejado.
Conclusão: quando a inferência multi-GPU faz sentido
A demonstração do Dynamo-Triton mostra que a inferência multi-GPU pode reduzir de forma significativa a latência de modelos generativos longos sem exigir que o cliente coordene cada GPU individualmente. No caso do Cosmos 3 Nano, o tempo de geração caiu de 156,595 para 34,183 segundos com oito GPUs, enquanto as chamadas do transformador alcançaram aceleração de 6,09 vezes.
O detalhe mais importante, porém, está além do número chamativo: o ganho depende de um plano TensorRT distribuído, de comunicação eficiente e de um fluxo no qual reduzir a espera vale mais do que minimizar a quantidade de GPUs usada por solicitação.
Portanto, a integração parece especialmente relevante para equipes que precisam servir modelos generativos com baixa latência e preferem manter uma interface de inferência simples. Para decidir se ela é adequada, será necessário medir também concorrência, custo, throughput e qualidade no ambiente real. A inferência multi-GPU resolve uma parte difícil do problema — coordenar a execução distribuída —, mas a escolha final continua sendo uma questão de engenharia e economia.