Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. A NVIDIA anunciou o Kumo Tabular, um modelo aberto criado para fazer previsões em dados tabulares sem treinamento específico, ajuste de hiperparâmetros ou engenharia manual de recursos. A proposta chama atenção porque grande parte do machine learning usado em empresas ainda depende justamente desse processo trabalhoso. Mas como um modelo pré-treinado consegue lidar com tabelas tão diferentes entre si?
O Kumo Tabular tenta responder a essa questão usando aprendizado em contexto: em vez de atualizar os pesos do modelo para cada novo problema, ele recebe linhas rotuladas como contexto e prevê os rótulos de novas linhas em uma única passagem.
O que é o NVIDIA Kumo Tabular
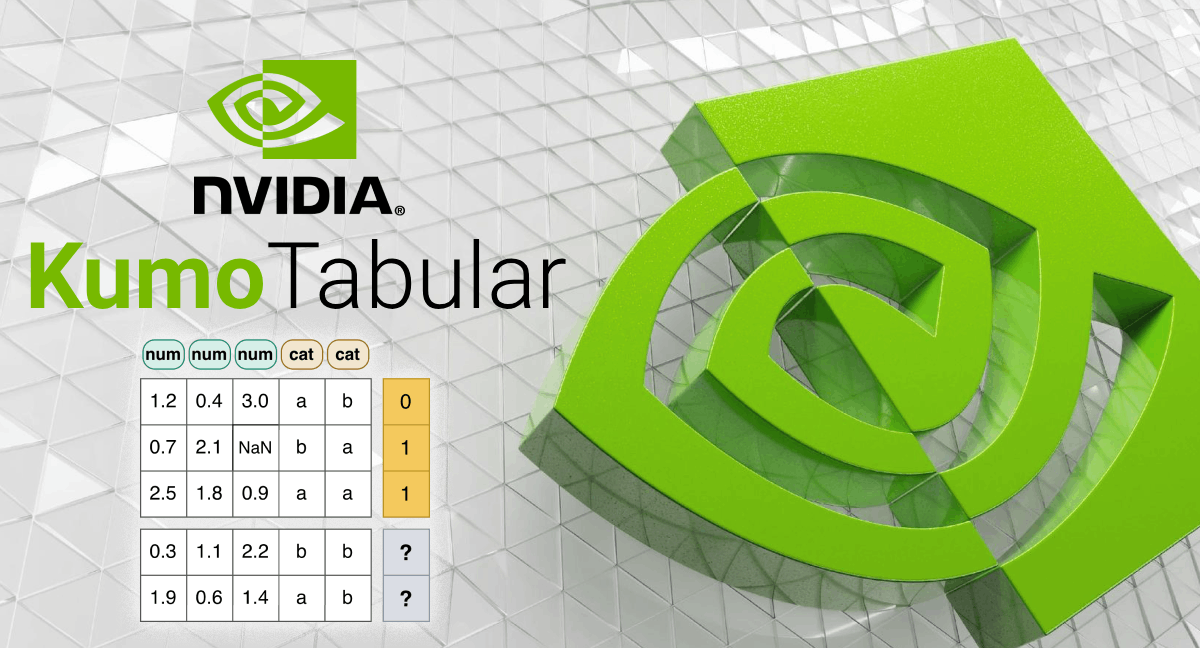
O NVIDIA Kumo Tabular é um modelo de base aberto para dados tabulares. Ele pode realizar tarefas de classificação e regressão a partir de uma tabela com linhas rotuladas e linhas que precisam de previsão.
Na classificação, o modelo retorna probabilidades para as classes. Na regressão, produz previsões numéricas e estimativas de incerteza. Segundo a NVIDIA, o modelo está disponível em três tamanhos, com entre 28 milhões e 215 milhões de parâmetros, e pode ser executado por meio da biblioteca de código aberto structured-data-models.
A empresa afirma que o Kumo Tabular foi desenvolvido para uso comercial sob a licença OpenMDW-1.1. Os pesos estão disponíveis no Hugging Face.
Como o NVIDIA Kumo Tabular funciona
O modelo utiliza uma arquitetura Transformer adaptada à estrutura de tabelas. Isso significa que ele precisa interpretar três relações diferentes: o significado de cada valor dentro de sua coluna, a interação entre as colunas de uma mesma linha e a relação entre as linhas usadas como contexto e aquelas que receberão previsões.
Embeddings de células e linhas
Os valores numéricos e categóricos são transformados em representações que preservam informações sobre seus tipos. Valores ausentes recebem tratamento próprio, sem exigir imputação prévia. Depois, o modelo combina as informações das células para formar uma representação de cada linha.
Um mecanismo de atenção observa os valores dentro de uma coluna para entender se determinado dado é comum ou extremo naquele contexto. Outro observa as colunas de uma mesma linha para aprender como as características se relacionam. É uma diferença importante em relação a simplesmente tratar a tabela como uma sequência desorganizada de números.
Aprendizado em contexto
Na etapa final, as linhas de contexto interagem entre si, enquanto as linhas de consulta observam apenas o contexto disponível. Assim, o modelo consegue usar exemplos rotulados para fazer previsões sem ajustar novamente seus parâmetros.
Na prática, a promessa é semelhante à de mostrar alguns exemplos antes de pedir uma resposta, mas aplicada a tabelas. A vantagem potencial é reduzir o ciclo tradicional de coletar dados, criar recursos, testar configurações e treinar um modelo do zero para cada novo problema.
Como a NVIDIA treinou o Kumo Tabular
O Kumo Tabular foi pré-treinado exclusivamente com tabelas artificiais geradas por modelos causais estruturais. A NVIDIA criou tabelas com diferentes tamanhos, relações entre variáveis, tipos de dados e padrões de valores ausentes.
O gerador também inclui imperfeições comuns em dados reais, como categorias com muitos níveis, valores extremos, alvos de regressão com caudas pesadas e linhas duplicadas que podem apresentar rótulos diferentes. A ideia é que o modelo encontre uma variedade suficientemente ampla de situações antes de receber dados de uma aplicação real.
De acordo com a NVIDIA, as versões Small, Medium e Large foram treinadas com aproximadamente 35 milhões, 71 milhões e 137 milhões de tabelas artificiais, respectivamente. O treinamento ocorreu em etapas, começando com tabelas menores e avançando para contextos de até 60 mil linhas.
Desempenho do NVIDIA Kumo Tabular nos benchmarks
A NVIDIA avaliou os três tamanhos do Kumo Tabular no TabArena, comparando-os com modelos de árvores de decisão impulsionadas, AutoGluon e outros modelos de base para dados tabulares. A empresa afirma que o modelo alcançou o primeiro lugar geral, com ELO de 1950, e foi 17 vezes mais rápido que o LimiX-2 no ambiente de avaliação informado.
Também segundo os resultados divulgados pela empresa, o Kumo Tabular ficou em primeiro lugar no BeyondArena, com ELO de 1418 e pontuação de Improvability de 7,78%. No TALENT, obteve a melhor classificação geral considerando métricas de classificação e regressão. Já no ScoringBench, as versões Large e Medium ficaram em primeiro e segundo lugar no ranking médio.
Esses números são resultados apresentados pela própria NVIDIA e devem ser interpretados dentro das configurações e dos conjuntos de dados usados em cada benchmark. Um bom desempenho em avaliações públicas não elimina a necessidade de testar o modelo com dados separados da aplicação real.
Limitações do NVIDIA Kumo Tabular
O modelo trabalha diretamente com colunas numéricas e categóricas. Texto, imagens e marcas de tempo precisam ser convertidos em recursos por meio de pré-processamento. Além disso, uma única passagem cobre até dez classes; para problemas com mais classes, a biblioteca utiliza códigos de saída com correção de erros.
A própria NVIDIA alerta que a precisão pode cair quando as tabelas estão muito além das faixas observadas durante o treinamento ou quando as linhas de consulta vêm de uma distribuição diferente daquela usada como contexto. Por isso, validação, calibração e monitoramento continuam sendo necessários.
Em outras palavras, o Kumo Tabular pode reduzir bastante o trabalho inicial, mas não transforma um problema de dados em algo automático. Usá-lo sem verificar a qualidade das previsões seria como colocar um piloto automático em uma estrada desconhecida e nunca olhar o painel.
O que o NVIDIA Kumo Tabular muda na prática
O lançamento indica uma mudança de direção no machine learning tabular. Durante anos, modelos baseados em árvores foram a escolha padrão para tabelas empresariais, e continuam sendo ferramentas fortes. A novidade é tentar criar um modelo que carregue conhecimento geral sobre estruturas tabulares e possa ser aplicado a novas tarefas com poucos exemplos.
Se a abordagem funcionar de maneira consistente fora dos benchmarks, equipes poderão testar previsões iniciais com menos código e menos etapas de preparação. Isso pode ser útil em cenários como análise de clientes, risco, demanda, preços, transações e sensores.
A resposta à pergunta do início, portanto, está no aprendizado em contexto combinado com o pré-treinamento em milhões de tabelas artificiais. O modelo não conhece automaticamente o negócio da empresa, mas chega ao problema com uma noção mais ampla de como dados tabulares costumam se comportar.
O lançamento do NVIDIA Kumo Tabular não elimina a necessidade de especialistas, validação ou engenharia de dados. Ele tenta deslocar parte do esforço: menos tempo construindo cada modelo do zero e mais tempo verificando se as previsões fazem sentido, são confiáveis e podem ser usadas com segurança.