Tempo de leitura: 5 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. A NVIDIA apresentou o Topograph, um toolkit de código aberto criado para ajudar Kubernetes, Slurm e Slinky a posicionar cargas de trabalho de IA de acordo com a topologia física do cluster. A ideia parece simples: colocar GPUs próximas quando elas precisam trocar muitos dados. Na prática, porém, essa decisão depende de informações que mudam conforme nós, switches e domínios de aceleradores entram ou saem do ambiente.
Esse detalhe é importante porque uma carga distribuída pode ter GPUs disponíveis e, ainda assim, perder desempenho ao atravessar links congestionados ou domínios de rede distantes. O agendamento consciente da topologia tenta evitar justamente esse desperdício, mantendo os schedulers informados sobre a organização real da infraestrutura.
Como funciona o agendamento consciente da topologia com o NVIDIA Topograph
O Topograph descobre como os componentes do cluster estão conectados por meio de APIs de provedores de nuvem ou de sistemas de rede instalados no local. Em seguida, normaliza essas informações em um modelo comum e as transforma no formato esperado pelo gerenciador de cargas de trabalho.
Em Kubernetes, o toolkit pode publicar a localidade como labels nos nós. No Slurm, pode gerar configurações de topologia. Em ambientes Slinky, que executam Slurm sobre Kubernetes, o resultado pode ser armazenado em ConfigMaps. Dessa forma, o scheduler deixa de enxergar apenas uma lista de máquinas com GPUs e passa a considerar também a distância lógica entre elas.
É como organizar uma mudança: não basta saber quais caminhões estão disponíveis; também é preciso entender quais estão no mesmo depósito e quais exigirão uma longa viagem por estradas congestionadas. Em treinamentos e inferências distribuídas, essa distância pode influenciar a comunicação entre GPUs e, consequentemente, o aproveitamento da infraestrutura.
Por que o agendamento consciente da topologia importa para cargas de IA
Modelos distribuídos trocam dados continuamente durante o treinamento e a inferência. Quando os processos são espalhados por domínios pouco eficientes, o tráfego pode atravessar mais switches e links compartilhados. O resultado pode ser maior latência, congestionamento e GPUs aguardando dados em vez de executar cálculos.
Segundo a NVIDIA, tecnologias como NVLink, NVLink Switch, InfiniBand e Spectrum-X oferecem diferentes formas de conectividade de alta largura de banda. Porém, o scheduler só consegue aproveitar essas relações se tiver uma visão atualizada da infraestrutura. Uma configuração feita manualmente pode envelhecer rapidamente depois de uma expansão do cluster, uma alteração de rede ou a substituição de nós.
É nesse ponto que o Topograph tenta resolver um problema operacional: regenerar a representação da topologia quando mudanças observadas no ambiente exigem uma atualização. O objetivo não é apenas produzir um mapa bonito da rede, mas entregar ao scheduler dados que possam influenciar decisões concretas de posicionamento.
O que muda no agendamento consciente da topologia em Kubernetes
O scheduler padrão do Kubernetes não descobre sozinho toda a hierarquia física dos interconectores. Com o Topograph, os nós podem receber labels que representam níveis de proximidade, como o switch mais próximo e camadas sucessivas da rede. Também é possível indicar domínios e subdomínios de aceleradores.
Esses labels podem ser usados em regras de afinidade entre Pods. Uma aplicação pode, por exemplo, preferir colocar seus processos no mesmo domínio de rede ou dentro de uma região mais próxima, reduzindo a probabilidade de espalhamento desnecessário.
Há uma limitação importante: o scheduler padrão posiciona Pods individualmente. Por isso, uma preferência de afinidade não garante necessariamente uma colocação globalmente ideal para um conjunto inteiro de processos. Para cargas que precisam ser iniciadas juntas, o Topograph pode trabalhar com ferramentas como o serviço de inferência multi-GPU da NVIDIA como parte de um contexto maior de infraestrutura distribuída, enquanto KAI Scheduler e Kueue oferecem mecanismos mais específicos de posicionamento coordenado.
Topograph e KAI Scheduler
O KAI Scheduler permite organizar os labels em uma hierarquia e aplicar requisitos de colocação a Jobs com vários Pods. Um trabalho pode exigir que todos os seus componentes permaneçam dentro de determinado domínio de topologia ou apenas preferir uma região mais próxima quando houver recursos disponíveis.
Na prática, isso aproxima a decisão de agendamento do formato da carga. Um treinamento que exige quatro GPUs pode ser tratado como um grupo, em vez de quatro solicitações independentes que acabam espalhadas pelo cluster.
Como o Topograph mantém o mapa do cluster atualizado
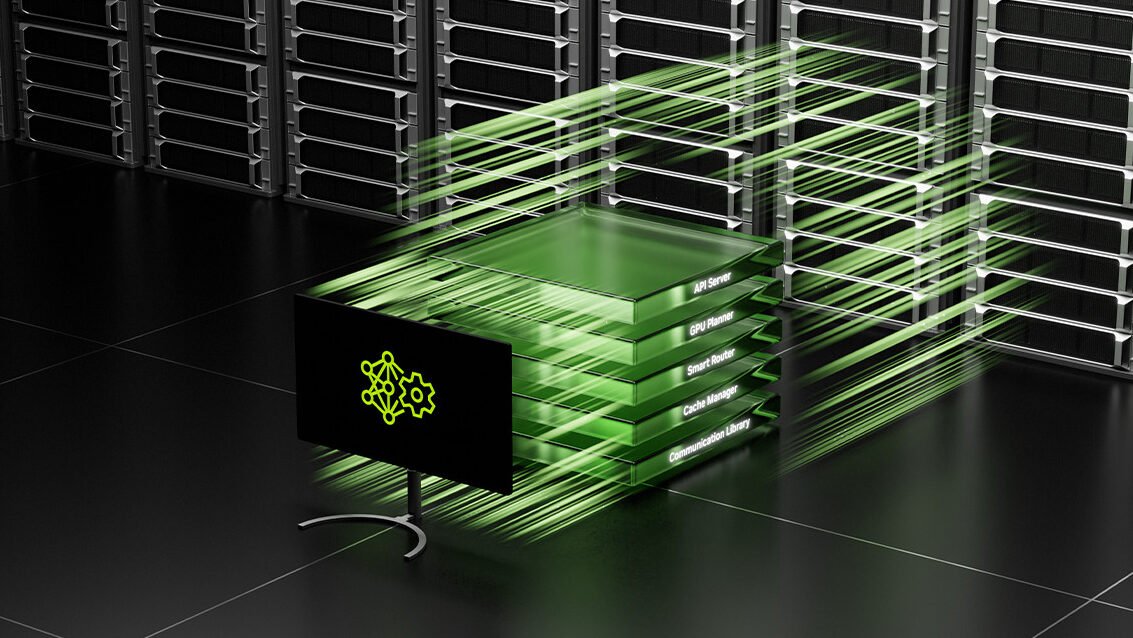
A arquitetura do toolkit combina um servidor de API, observadores de nós, um componente para coletar dados por nó, provedores de topologia e engines de saída. O servidor recebe solicitações de geração; o provedor consulta a nuvem ou a malha de rede; e a engine publica o resultado para o ambiente escolhido.
No Kubernetes, observadores podem acompanhar alterações em nós ou Pods e solicitar uma nova geração. O sistema também agrega solicitações repetidas durante um intervalo de espera, evitando executar o mesmo trabalho várias vezes quando muitos eventos acontecem em sequência.
A atualização, contudo, depende do que o provedor consegue observar. O Topograph representa a topologia informada pelo ambiente, não uma intenção administrativa. Uma mudança física na rede pode não aparecer imediatamente se não houver um evento ou mecanismo de descoberta capaz de detectá-la.
Quais ambientes podem usar o agendamento consciente da topologia
O material publicado pela NVIDIA informa integrações com Google Cloud, Lambda, Nebius, Nscale e Oracle Cloud Infrastructure. Para instalações locais, o Topograph pode trabalhar com ambientes InfiniBand, fabrics Spectrum-X gerenciados pelo NetQ e domínios Multi-Node NVLink, de acordo com o provedor e a configuração escolhidos.
O toolkit também oferece engines para Kubernetes, Slurm, Slinky, Node Feature Discovery e saída em formato de grafo ou JSON orientado a instâncias. A disponibilidade de cada combinação varia conforme o ambiente. Por isso, operadores precisam consultar a documentação do projeto antes de assumir que determinado provedor suporta todos os formatos.
Em Kubernetes, a instalação pode ser feita com Helm. O projeto informa como requisitos Kubernetes 1.27 ou posterior, Helm 3.10 ou 4.x, permissões para usar o kubectl e um provedor compatível. Também há utilitários de simulação para testar modelos de nós e switches sem depender imediatamente de hardware de produção.
O que a chegada do Topograph representa para a infraestrutura de IA
A apresentação do Topograph mostra que o desempenho de um cluster de IA não depende apenas do número de GPUs instaladas. A forma como elas são conectadas e agrupadas também influencia o resultado, especialmente em cargas distribuídas e serviços que precisam atender muitas solicitações simultâneas.
Ao transformar a topologia física em dados utilizáveis por schedulers, o projeto tenta reduzir a distância entre a infraestrutura e as decisões de software. O ganho esperado não vem de uma nova GPU, mas de evitar que as existentes passem parte do tempo esperando comunicação.
O agendamento consciente da topologia não elimina todos os problemas de capacidade, rede ou balanceamento. Ele oferece, porém, uma camada de informação que pode tornar essas decisões mais coerentes à medida que o cluster cresce. Para equipes que operam Kubernetes, Slurm ou Slinky em fábricas de IA, esse mapa atualizado pode ser a diferença entre simplesmente ocupar GPUs e utilizá-las de maneira eficiente.