Tempo de leitura: 6 minutos
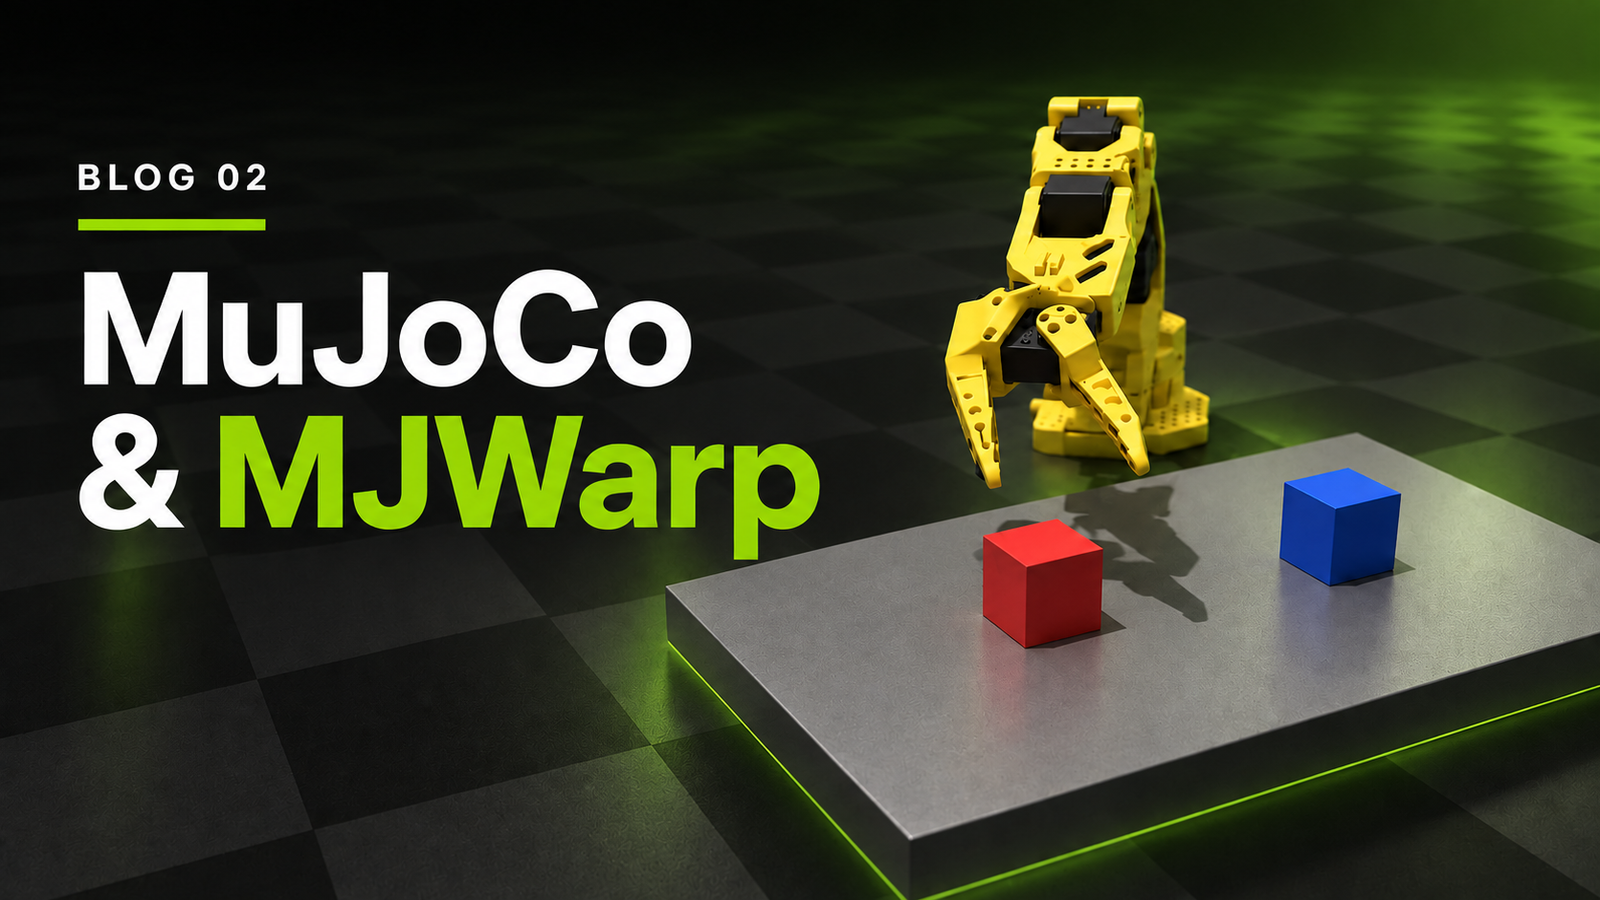
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Em um artigo publicado em 23 de setembro de 2026, a NVIDIA explicou como usar Warp e MJWarp para ampliar a escala de simulações de robótica em GPUs. A proposta parte de um fluxo conhecido no MuJoCo e mostra como chegar a até 2.048 ambientes paralelos usando o braço SO-101.
A diferença mais importante não está necessariamente em fazer uma única simulação terminar mais rápido. O objetivo é avançar muitos mundos ao mesmo tempo, mantendo os estados e os dados de aprendizagem próximos da GPU. Essa mudança altera a forma de medir desempenho e ajuda a explicar por que a abordagem pode ser útil em treinamento por reforço e em tarefas que exigem grande volume de amostras.
Como Warp e MJWarp aceleram simulações de robótica
O NVIDIA Warp é um framework Python para escrever kernels de alto desempenho executados em CPU ou CUDA. O código é compilado Just in Time e pode aproveitar recursos como fusão de kernels, CUDA Graphs, diferenciação automática e interoperabilidade com PyTorch e JAX.
O MJWarp leva a física compatível do MuJoCo para esse ambiente. O modelo continua sendo carregado e compilado a partir de um arquivo MJCF, mas os estados de vários mundos independentes ficam organizados em estruturas na GPU. Com uma chamada a mjw.step, o sistema avança todo o lote, em vez de executar cada ambiente individualmente no processador.
Isso cria uma distinção essencial: latência é o tempo necessário para avançar uma simulação, enquanto throughput agregado é o número total de passos de mundo concluídos por segundo. Para um único robô controlado em tempo real, o MuJoCo no CPU pode continuar sendo a escolha mais simples. Para gerar muitas experiências em paralelo, o MJWarp passa a fazer mais sentido.
O que muda ao levar o MuJoCo para o MJWarp
A migração começa com um modelo MuJoCo comum. O artigo usa uma cena do SO-101 com uma mesa e dois cubos, em uma tarefa de empilhamento. Antes de pensar em milhares de ambientes, a recomendação é estabelecer uma linha de base no CPU e verificar se a tarefa realmente funciona.
Depois, o modelo pode ser enviado para a GPU com mjw.put_model(). O estado inicial é transferido com mjw.put_data() ou criado com mjw.make_data(), dependendo de ser necessário preservar um estado já inicializado. A principal mudança estrutural é a inclusão da dimensão de mundos: um vetor como qpos deixa de representar apenas um robô e passa a ter uma linha para cada ambiente paralelo.
A validação de um único mundo é uma etapa importante. O estado pode ser copiado de volta para o MuJoCo no CPU para comparar posições, velocidades e o resultado da tarefa. Porém, essas cópias sincronizam a GPU e transferem dados para a memória do host. Por isso, servem para conferir a paridade entre os fluxos, mas não devem fazer parte de um benchmark de throughput.
Também é necessário dimensionar corretamente os buffers de contatos e restrições. Parâmetros como nconmax, naconmax e njmax precisam suportar o momento mais exigente da tarefa. Um estouro pode invalidar a simulação, mesmo que a execução continue acompanhada de um aviso.
Como Warp e MJWarp escalam para 2.048 mundos
Depois que o resultado de um mundo é validado, o estado inicial pode ser replicado para o lote desejado. No exemplo apresentado, a escala chega a 2.048 ambientes independentes. A cada passo, os controles permanecem organizados na GPU e o sistema evita transferências pelo barramento PCIe durante o caminho principal da simulação.
Os CUDA Graphs ajudam a reduzir o custo de lançar repetidamente a sequência de kernels. O gráfico deve ser capturado novamente quando buffers, modelo ou número de mundos forem alterados. Entre as execuções, os controles podem ser atualizados diretamente nos buffers existentes.
O cuidado com a medição é tão importante quanto a configuração. Como os lançamentos CUDA são assíncronos, um cronômetro iniciado apenas em Python pode registrar o tempo de enfileiramento, não o tempo real de execução na GPU. O procedimento indicado é aquecer a execução, sincronizar antes e depois da região medida e informar tanto os milissegundos por passo em lote quanto os passos de mundo por segundo.
O artigo também destaca que o resultado depende da cena, das configurações de simulação e do hardware. Aumentar o número de mundos costuma elevar o throughput até que a memória ou a capacidade computacional se tornem limitantes. Por isso, uma comparação de latência com apenas um ambiente não prova que a abordagem será melhor em uma carga paralela.
Por que Warp e MJWarp importam para a robótica
A combinação apresentada pela NVIDIA ocupa uma camada específica da pilha de simulação. O Warp fornece a linguagem e os kernels; o MJWarp implementa a física do MuJoCo em escala de GPU; e a cena continua baseada em ativos e tarefas conhecidos do ecossistema MuJoCo.
Esse fluxo ainda não é um sistema completo de treinamento. O artigo concentra-se em preparar a cena, migrar o modelo, validar a equivalência e medir o desempenho. Camadas posteriores, como gerenciadores de tarefas, sensores, formatos de ativos e loops de treinamento, podem ser integradas por projetos como mjlab, MuJoCo Playground e Isaac Lab com Newton.
Para quem trabalha com agentes de IA para simulação e cenas 3D de robótica, a ideia central é especialmente relevante: uma cena bem definida precisa ser replicada, validada e medida antes de alimentar um processo automatizado. A GPU pode oferecer escala, mas não corrige um modelo incompatível, uma tarefa mal definida ou uma métrica calculada de forma incorreta.
Em síntese, o caminho sugerido é gradual: primeiro validar o MuJoCo no CPU, depois executar um único mundo no MJWarp, dimensionar contatos e restrições, escalar o lote e só então medir o throughput. O ganho não deve ser presumido a partir de uma única execução; ele precisa aparecer em uma curva de desempenho obtida no hardware e na cena que realmente serão usados.