Generic selectors
Exact matches only
Search in title
Search in content
Post Type Selectors

Pruning de LLMs usa um problema de física para escolher quais blocos remover

Pruning de LLMs usa um problema de física para escolher quais blocos remover
Uma nova abordagem transforma o pruning de LLMs em um problema de otimização inspirado na física para escolher combinações de blocos com menor perda de desempenho.

Índice

Tempo de leitura: 6 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Reduzir o tamanho de um modelo de linguagem pode parecer uma questão simples: basta identificar os blocos menos importantes e removê-los. Na prática, porém, cada bloco interage com os demais, e uma escolha aparentemente inofensiva pode derrubar o desempenho do modelo. É justamente esse problema que uma nova abordagem de pruning de LLMs tenta resolver usando conceitos da física estatística.

Em um artigo publicado em 21 de setembro de 2026, a Multiverse Computing descreveu um método que transforma a remoção de blocos de um transformer em um problema de otimização binária com estrutura semelhante a um sistema de spins. A proposta permite avaliar muitas combinações sem executar o modelo em cada tentativa e, segundo os autores, apresenta ganhos especialmente relevantes quando a compressão é agressiva.

Como o pruning de LLMs vira um problema de física

Modelos de linguagem são formados por várias camadas ou blocos transformer. Remover blocos inteiros reduz a profundidade do modelo e pode trazer ganhos previsíveis de velocidade e economia de memória. A dificuldade está em escolher quais blocos eliminar sem comprometer a qualidade das respostas.

Métodos tradicionais costumam avaliar cada bloco de forma isolada, usando medidas como magnitude, sensibilidade ou influência. Essa estratégia funciona como se a contribuição de cada bloco fosse independente. Mas os blocos não trabalham como ilhas: retirar o bloco 20 pode ter um efeito muito diferente dependendo de os blocos 19 ou 24 também terem sido removidos.

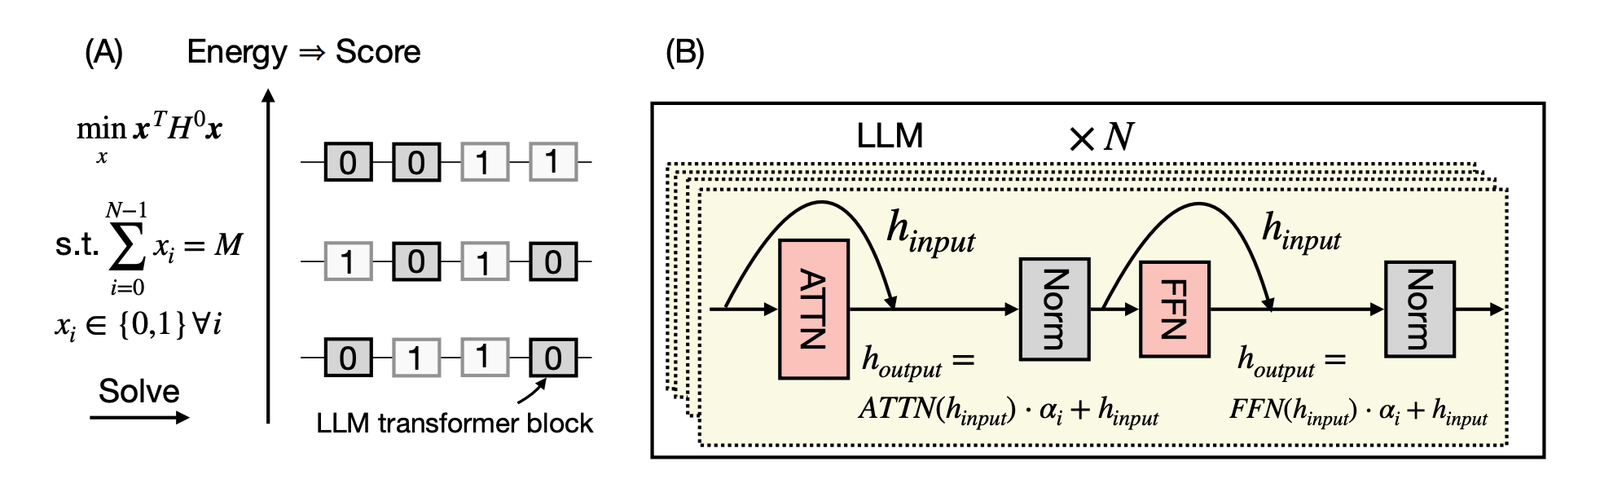
Por isso, a equipe trata cada decisão como uma variável binária. O valor 0 representa um bloco mantido, enquanto o valor 1 representa um bloco removido. O objetivo é encontrar a combinação de exatamente M blocos que minimize uma função de energia baseada em uma aproximação da Hessiana do modelo.

Nessa formulação, os elementos diagonais representam a importância individual dos blocos. Já os elementos fora da diagonal representam os acoplamentos entre pares de blocos. É essa segunda informação que diferencia o método de uma simples lista de blocos menos importantes.

Por que as interações importam no pruning de LLMs

O número de combinações possíveis cresce rapidamente conforme aumenta a quantidade de blocos que pode ser removida. Testar cada alternativa executando o modelo e medindo seu desempenho seria caro demais, principalmente em modelos grandes.

A solução proposta calcula a Hessiana uma única vez a partir de passagens de ida e volta sobre um pequeno conjunto de calibração. Depois disso, cada configuração candidata pode ser avaliada por meio de um cálculo de energia relativamente barato. A mesma estrutura também pode ser reutilizada para diferentes níveis de compressão.

Essa mudança de perspectiva é importante porque transforma a pergunta “qual bloco é menos importante?” em outra pergunta: “qual conjunto de blocos forma a melhor configuração?”. No pruning de LLMs, essa diferença pode ser decisiva quando a remoção atinge uma parcela grande da rede.

Solvers exatos, tabu search e estados de baixa energia

Em modelos menores ou em problemas com poucas combinações, os pesquisadores conseguem enumerar configurações diretamente em uma GPU. O material relata, por exemplo, que a remoção de 8 entre 80 blocos do Llama-3.3-70B envolve cerca de 29 bilhões de possibilidades e levou aproximadamente dois dias para ser explorada por força bruta.

Quando a enumeração deixa de ser viável, o problema pode ser convertido para uma formulação QUBO e encaminhado a solvers clássicos, quânticos ou inspirados em computação quântica. Entre as abordagens citadas estão quantum annealing, QAOA, tabu search e métodos especializados de branch-and-bound.

Um ponto interessante é que o objetivo prático não precisa ser encontrar a configuração matematicamente perfeita. O método busca gerar rapidamente várias configurações de baixa energia que possam ser testadas. Como a energia funciona como uma aproximação da qualidade final, esse conjunto de candidatos oferece alternativas sem exigir benchmarks completos para todas as combinações.

O melhor resultado nem sempre está no estado fundamental

A menor energia não garante automaticamente o melhor modelo. A aproximação usada para calcular a energia é útil, mas não é perfeita. Por isso, a equipe também analisa estados excitados, ou seja, configurações que estão próximas do menor valor de energia.

Em um exemplo com o Llama-3.1-8B-Instruct, removendo 16 dos 32 blocos, o 17º estado excitado foi o primeiro entre os principais candidatos a sugerir a remoção de um bloco próximo do início da rede. Depois de um leve retreinamento, essa configuração superou o estado fundamental em vários benchmarks.

O resultado desafia a ideia de que a melhor estratégia consiste sempre em remover um trecho consecutivo de blocos no meio ou no final do modelo. Em vez de uma tesoura que corta uma única faixa, o método funciona mais como um editor que escolhe vários pontos da estrutura levando em conta suas relações.

Resultados em Llama, Qwen e modelos híbridos

De acordo com os resultados apresentados, a abordagem chamada CBO teve desempenho semelhante ou superior a métodos de referência em Llama-3.1-8B-Instruct, Qwen3-14B e Llama-3.3-70B-Instruct. A vantagem cresceu nos cenários de compressão mais profunda.

No Llama-3.3-70B-Instruct, sem retreinamento, a remoção de 32 dos 80 blocos levou a um resultado de 76,6 no MMLU, contra 59,3 do método baseado em influência de blocos. Com 40 blocos removidos, o CBO alcançou 76,9, enquanto a abordagem comparada ficou em 54,0. O artigo descreve essa diferença como uma vantagem de quase 23 pontos no cenário mais agressivo.

No Qwen3-14B, com 12 dos 40 blocos removidos, a vantagem relatada no MMLU foi de aproximadamente 10 pontos. Em níveis menores de compressão, os métodos ficaram mais próximos, o que sugere que os acoplamentos entre blocos se tornam especialmente importantes quando muitas partes do modelo precisam ser eliminadas.

A equipe também aplicou a técnica ao NVIDIA Nemotron-3-Nano-30B-A3B-FP8, uma arquitetura híbrida que combina camadas Mamba2, atenção e mistura de especialistas. Essa diversidade aproxima o caso de modelos discutidos em análises sobre modelos densos e MoE, nos quais diferentes tipos de componentes podem ter níveis distintos de redundância.

Segundo o material, o método encontrou configurações que superaram a técnica de influência de blocos em testes como AIME25 e GPQA ao remover camadas MoE ou de atenção. A formulação não depende de uma pilha homogênea de transformers: ela considera as relações entre as decisões, independentemente do tipo específico de bloco.

O que essa abordagem muda no pruning de LLMs

A principal contribuição não é apenas remover mais blocos, mas mudar a maneira de procurar boas configurações. Em vez de classificar componentes individualmente, o método tenta capturar a estrutura coletiva da rede.

Isso também torna a técnica compatível com outras formas de compressão, como quantização, redução de baixa ordem, poda de largura e destilação de conhecimento. Na prática, o pruning de LLMs pode ser usado como uma etapa de um pipeline maior, e não como uma alternativa isolada às demais estratégias.

Há, entretanto, uma ressalva importante: os números apresentados vêm de um trabalho específico e devem ser interpretados dentro dos modelos, benchmarks e condições descritos pelos autores. A energia calculada é uma proxy, não uma garantia de desempenho. Por isso, a validação final dos candidatos continua necessária antes de colocar um modelo comprimido em produção.

A ideia central é simples de explicar, embora difícil de executar: remover blocos inteiros pode acelerar um LLM, mas escolher os blocos certos exige considerar as relações entre eles. Ao tratar essa seleção como um problema de otimização inspirado em sistemas de spins, a proposta procura explorar justamente a parte que os métodos individuais deixam de lado.

Se os resultados se confirmarem em mais arquiteturas e tarefas, essa abordagem poderá tornar a compressão profunda menos parecida com um corte no escuro e mais parecida com um projeto calculado. O modelo fica menor não porque qualquer bloco foi descartado, mas porque a combinação escolhida preserva melhor o comportamento que realmente importa.
Fontes

RECENTES

Como a Jump Trading amplia a pesquisa quantitativa com agentes de IA
A Jump Trading usa o GPT-6 Astra para ampliar pesquisas quantitativas com agentes de IA, combinando autonomia, coordenação de tarefas e revisão humana.
OpenAI compartilha avanços de IA na matemática com provas verificáveis
A OpenAI anunciou novos resultados matemáticos produzidos por um modelo interno, com provas formalizadas em Lean, dados sobre o processo e publicação em um repositório aberto.

LEIS MAIS


CONTINUE NO PLANKSNET

NVIDIA usa gêmeos digitais para validar mudanças em fábricas de IA
8 min de leitura
A NVIDIA apresentou uma abordagem que combina o DSX Air, o Brev e agentes de IA para testar configurações e integrações de fábricas de IA antes da implantação física.
NVIDIA cuOpt mPDLP leva a otimização linear a mais de 100 milhões de variáveis
5 min de leitura
A NVIDIA apresentou o cuOpt mPDLP, método multi-GPU que distribui problemas de programação linear com mais de 100 milhões de variáveis e reduz a pressão sobre memória e tempo de processamento.

VEJA TAMBÉM

Pruning de LLMs usa um problema de física para escolher quais blocos remover

Pruning de LLMs usa um problema de física para escolher quais blocos remover
Uma nova abordagem transforma o pruning de LLMs em um problema de otimização inspirado na física para escolher combinações de blocos com menor perda de desempenho.

Índice

Tempo de leitura: 6 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Reduzir o tamanho de um modelo de linguagem pode parecer uma questão simples: basta identificar os blocos menos importantes e removê-los. Na prática, porém, cada bloco interage com os demais, e uma escolha aparentemente inofensiva pode derrubar o desempenho do modelo. É justamente esse problema que uma nova abordagem de pruning de LLMs tenta resolver usando conceitos da física estatística.

Em um artigo publicado em 21 de setembro de 2026, a Multiverse Computing descreveu um método que transforma a remoção de blocos de um transformer em um problema de otimização binária com estrutura semelhante a um sistema de spins. A proposta permite avaliar muitas combinações sem executar o modelo em cada tentativa e, segundo os autores, apresenta ganhos especialmente relevantes quando a compressão é agressiva.

Como o pruning de LLMs vira um problema de física

Modelos de linguagem são formados por várias camadas ou blocos transformer. Remover blocos inteiros reduz a profundidade do modelo e pode trazer ganhos previsíveis de velocidade e economia de memória. A dificuldade está em escolher quais blocos eliminar sem comprometer a qualidade das respostas.

Métodos tradicionais costumam avaliar cada bloco de forma isolada, usando medidas como magnitude, sensibilidade ou influência. Essa estratégia funciona como se a contribuição de cada bloco fosse independente. Mas os blocos não trabalham como ilhas: retirar o bloco 20 pode ter um efeito muito diferente dependendo de os blocos 19 ou 24 também terem sido removidos.

Por isso, a equipe trata cada decisão como uma variável binária. O valor 0 representa um bloco mantido, enquanto o valor 1 representa um bloco removido. O objetivo é encontrar a combinação de exatamente M blocos que minimize uma função de energia baseada em uma aproximação da Hessiana do modelo.

Nessa formulação, os elementos diagonais representam a importância individual dos blocos. Já os elementos fora da diagonal representam os acoplamentos entre pares de blocos. É essa segunda informação que diferencia o método de uma simples lista de blocos menos importantes.

Por que as interações importam no pruning de LLMs

O número de combinações possíveis cresce rapidamente conforme aumenta a quantidade de blocos que pode ser removida. Testar cada alternativa executando o modelo e medindo seu desempenho seria caro demais, principalmente em modelos grandes.

A solução proposta calcula a Hessiana uma única vez a partir de passagens de ida e volta sobre um pequeno conjunto de calibração. Depois disso, cada configuração candidata pode ser avaliada por meio de um cálculo de energia relativamente barato. A mesma estrutura também pode ser reutilizada para diferentes níveis de compressão.

Essa mudança de perspectiva é importante porque transforma a pergunta “qual bloco é menos importante?” em outra pergunta: “qual conjunto de blocos forma a melhor configuração?”. No pruning de LLMs, essa diferença pode ser decisiva quando a remoção atinge uma parcela grande da rede.

Solvers exatos, tabu search e estados de baixa energia

Em modelos menores ou em problemas com poucas combinações, os pesquisadores conseguem enumerar configurações diretamente em uma GPU. O material relata, por exemplo, que a remoção de 8 entre 80 blocos do Llama-3.3-70B envolve cerca de 29 bilhões de possibilidades e levou aproximadamente dois dias para ser explorada por força bruta.

Quando a enumeração deixa de ser viável, o problema pode ser convertido para uma formulação QUBO e encaminhado a solvers clássicos, quânticos ou inspirados em computação quântica. Entre as abordagens citadas estão quantum annealing, QAOA, tabu search e métodos especializados de branch-and-bound.

Um ponto interessante é que o objetivo prático não precisa ser encontrar a configuração matematicamente perfeita. O método busca gerar rapidamente várias configurações de baixa energia que possam ser testadas. Como a energia funciona como uma aproximação da qualidade final, esse conjunto de candidatos oferece alternativas sem exigir benchmarks completos para todas as combinações.

O melhor resultado nem sempre está no estado fundamental

A menor energia não garante automaticamente o melhor modelo. A aproximação usada para calcular a energia é útil, mas não é perfeita. Por isso, a equipe também analisa estados excitados, ou seja, configurações que estão próximas do menor valor de energia.

Em um exemplo com o Llama-3.1-8B-Instruct, removendo 16 dos 32 blocos, o 17º estado excitado foi o primeiro entre os principais candidatos a sugerir a remoção de um bloco próximo do início da rede. Depois de um leve retreinamento, essa configuração superou o estado fundamental em vários benchmarks.

O resultado desafia a ideia de que a melhor estratégia consiste sempre em remover um trecho consecutivo de blocos no meio ou no final do modelo. Em vez de uma tesoura que corta uma única faixa, o método funciona mais como um editor que escolhe vários pontos da estrutura levando em conta suas relações.

Resultados em Llama, Qwen e modelos híbridos

De acordo com os resultados apresentados, a abordagem chamada CBO teve desempenho semelhante ou superior a métodos de referência em Llama-3.1-8B-Instruct, Qwen3-14B e Llama-3.3-70B-Instruct. A vantagem cresceu nos cenários de compressão mais profunda.

No Llama-3.3-70B-Instruct, sem retreinamento, a remoção de 32 dos 80 blocos levou a um resultado de 76,6 no MMLU, contra 59,3 do método baseado em influência de blocos. Com 40 blocos removidos, o CBO alcançou 76,9, enquanto a abordagem comparada ficou em 54,0. O artigo descreve essa diferença como uma vantagem de quase 23 pontos no cenário mais agressivo.

No Qwen3-14B, com 12 dos 40 blocos removidos, a vantagem relatada no MMLU foi de aproximadamente 10 pontos. Em níveis menores de compressão, os métodos ficaram mais próximos, o que sugere que os acoplamentos entre blocos se tornam especialmente importantes quando muitas partes do modelo precisam ser eliminadas.

A equipe também aplicou a técnica ao NVIDIA Nemotron-3-Nano-30B-A3B-FP8, uma arquitetura híbrida que combina camadas Mamba2, atenção e mistura de especialistas. Essa diversidade aproxima o caso de modelos discutidos em análises sobre modelos densos e MoE, nos quais diferentes tipos de componentes podem ter níveis distintos de redundância.

Segundo o material, o método encontrou configurações que superaram a técnica de influência de blocos em testes como AIME25 e GPQA ao remover camadas MoE ou de atenção. A formulação não depende de uma pilha homogênea de transformers: ela considera as relações entre as decisões, independentemente do tipo específico de bloco.

O que essa abordagem muda no pruning de LLMs

A principal contribuição não é apenas remover mais blocos, mas mudar a maneira de procurar boas configurações. Em vez de classificar componentes individualmente, o método tenta capturar a estrutura coletiva da rede.

Isso também torna a técnica compatível com outras formas de compressão, como quantização, redução de baixa ordem, poda de largura e destilação de conhecimento. Na prática, o pruning de LLMs pode ser usado como uma etapa de um pipeline maior, e não como uma alternativa isolada às demais estratégias.

Há, entretanto, uma ressalva importante: os números apresentados vêm de um trabalho específico e devem ser interpretados dentro dos modelos, benchmarks e condições descritos pelos autores. A energia calculada é uma proxy, não uma garantia de desempenho. Por isso, a validação final dos candidatos continua necessária antes de colocar um modelo comprimido em produção.

A ideia central é simples de explicar, embora difícil de executar: remover blocos inteiros pode acelerar um LLM, mas escolher os blocos certos exige considerar as relações entre eles. Ao tratar essa seleção como um problema de otimização inspirado em sistemas de spins, a proposta procura explorar justamente a parte que os métodos individuais deixam de lado.

Se os resultados se confirmarem em mais arquiteturas e tarefas, essa abordagem poderá tornar a compressão profunda menos parecida com um corte no escuro e mais parecida com um projeto calculado. O modelo fica menor não porque qualquer bloco foi descartado, mas porque a combinação escolhida preserva melhor o comportamento que realmente importa.

Fontes

Pruning de LLMs usa um problema de física para escolher quais blocos remover

VEJA TAMBÉM