Tempo de leitura: 5 minutos
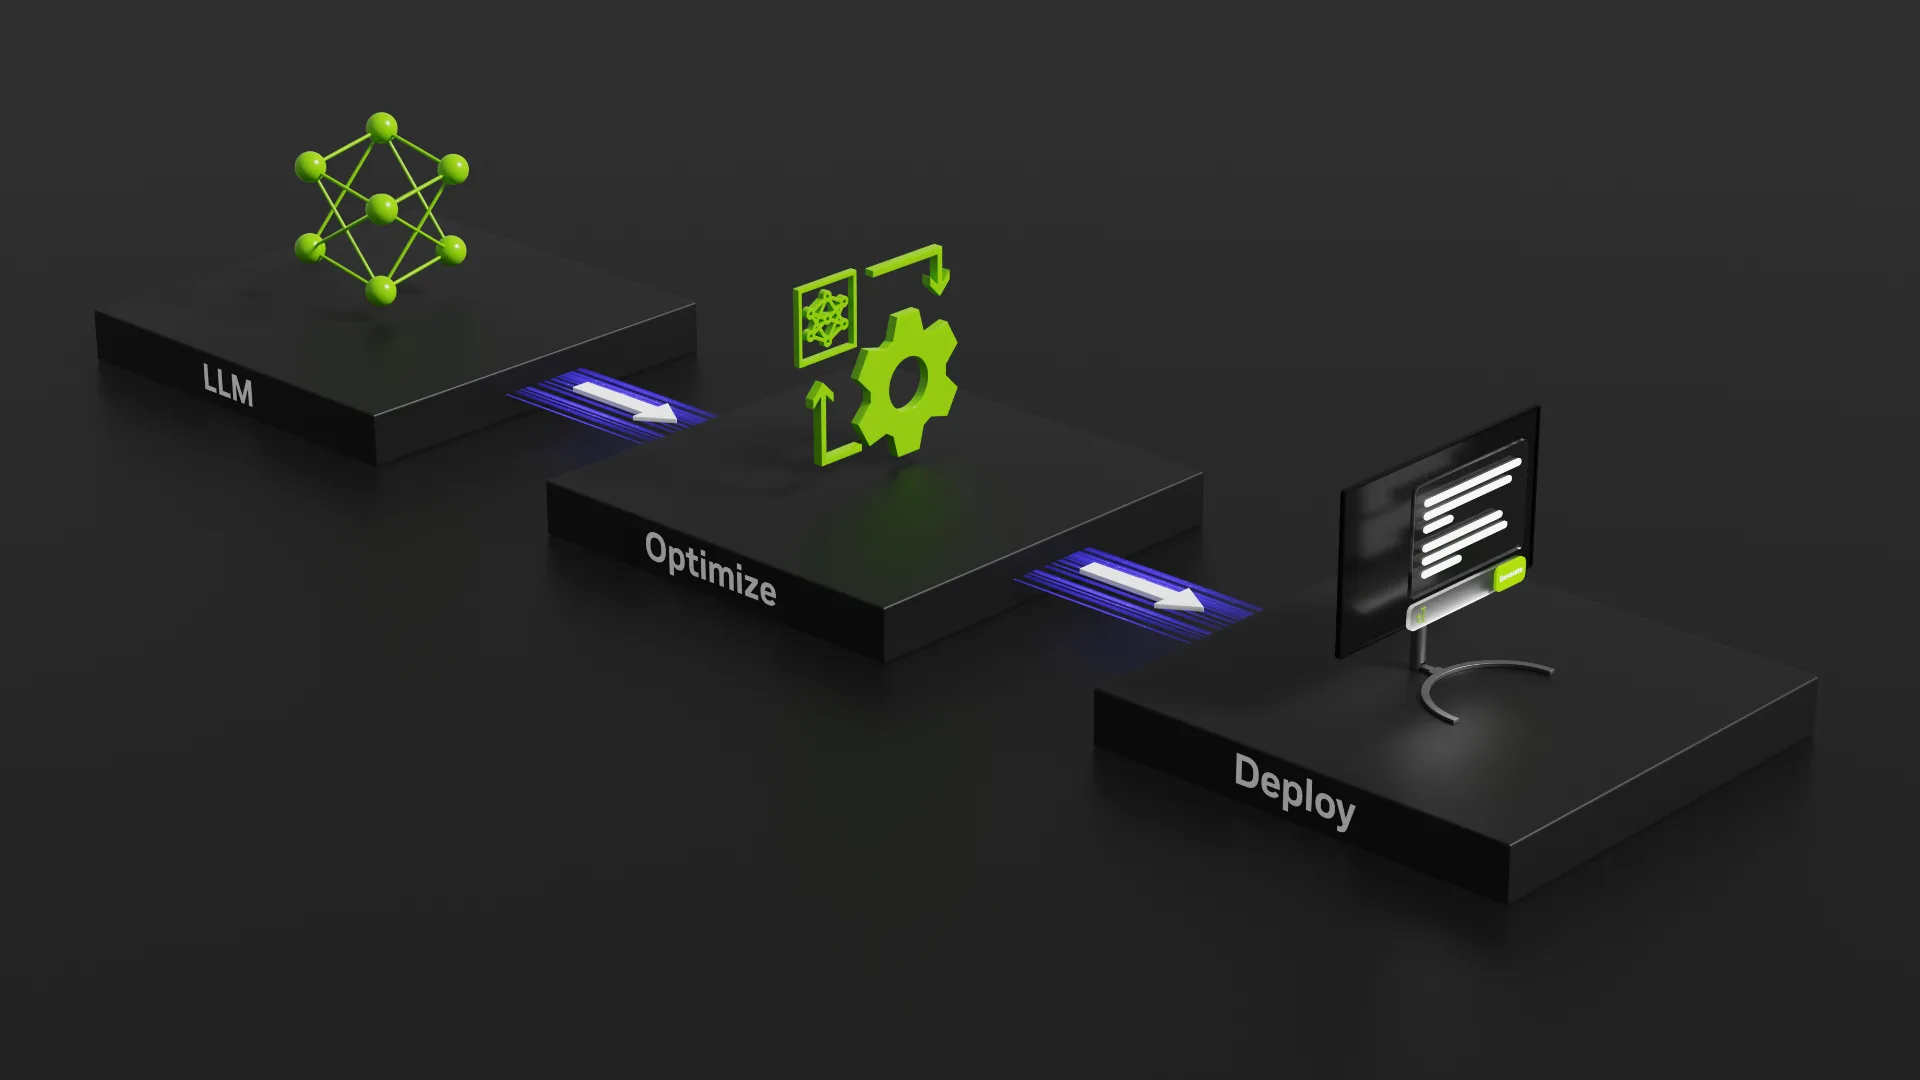
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. A NVIDIA informou que o TensorRT Edge-LLM concluiu o benchmark MLPerf Edge Agentic 6,4 vezes mais rápido do que a implementação de referência baseada em llama.cpp em um Jetson AGX Thor. O resultado chama atenção porque mede uma tarefa mais próxima do uso real de agentes de IA: o modelo precisa conversar com ferramentas, interpretar os resultados e continuar trabalhando ao longo de várias etapas.
Em vez de avaliar apenas a velocidade de uma resposta isolada, o teste acompanha uma trajetória completa, com conversas extensas e chamadas de funções. É justamente nesse cenário que o desempenho costuma cair. A pergunta é como o TensorRT Edge-LLM conseguiu manter a velocidade enquanto o contexto aumentava. A resposta envolve quantização, reutilização de cache e uma forma mais sofisticada de previsão de tokens.
TensorRT Edge-LLM conclui o benchmark de agentes de IA em 24 minutos
De acordo com os resultados divulgados pela NVIDIA em 16 de setembro de 2026, o TensorRT Edge-LLM executou o modelo Qwen3.6-27B em um único kit de desenvolvimento NVIDIA Jetson AGX Thor, com 128 GB de memória unificada e modo de energia MAXN.
O sistema alcançou 52,33 tokens por segundo e completou as 1.007 etapas do fluxo de desempenho em 24 minutos e 36 segundos. A execução de referência com llama.cpp levou 2 horas e 37 minutos. Na prática, isso representa uma redução de 6,4 vezes no tempo necessário para concluir a mesma carga de trabalho.
O benchmark também registrou tempo mediano de 247,12 milissegundos até o primeiro token, 14,68 milissegundos por token gerado e 87,94% de precisão geral no conjunto BFCL. Esses números não significam que todo uso de IA no dispositivo terá exatamente o mesmo desempenho, mas mostram o resultado de uma configuração específica, com hardware, modelo, parâmetros e software definidos.
TensorRT Edge-LLM enfrenta um teste pensado para agentes de IA
O MLPerf Edge Agentic não funciona como um teste simples de perguntas e respostas. O conjunto de desempenho reproduz 20 conversas de engenharia de software, totalizando 1.007 turnos gerados. Em cada etapa, o modelo recebe uma solicitação, produz uma chamada de ferramenta, observa o resultado e continua a conversa.
Esse detalhe muda completamente o problema. Conforme as ferramentas devolvem informações, o histórico cresce e pode chegar a aproximadamente 23,5 mil tokens. Se o sistema processar toda a conversa novamente a cada turno, o custo aumenta como uma mochila que recebe mais objetos sem nunca ser esvaziada.
Por isso, o benchmark verifica não apenas a rapidez da geração, mas também se o agente escolhe a função correta, produz argumentos válidos e evita chamar uma ferramenta quando ela não é necessária. A avaliação de precisão utiliza prompts do Berkeley Function Calling Leaderboard, enquanto a fase de desempenho mede a execução da trajetória completa.
TensorRT Edge-LLM combina quantização e reutilização de cache
Uma das bases do resultado foi o uso de NVFP4 nos pesos e nas ativações do Qwen3.6-27B, incluindo a saída do modelo de linguagem. O cache de chaves e valores, conhecido como KV cache, foi armazenado em FP8. Esses formatos reduzem o espaço ocupado pelos dados e diminuem a pressão sobre a memória, um fator importante em inferências com lotes pequenos.
O TensorRT Edge-LLM também identificou os prefixos de prompt que se repetiam entre os turnos e reutilizou as páginas já calculadas do KV cache. Como o Qwen3.6 possui uma arquitetura híbrida, o runtime ainda restaura estados recorrentes e partes do cache necessárias para continuar a execução corretamente.
Segundo a NVIDIA, cerca de 96% dos tokens de prompt foram atendidos a partir do cache quente. Dos 13,6 milhões de tokens presentes nos prompts ao longo da trajetória, apenas aproximadamente 0,5 milhão precisou passar novamente pela etapa de prefill. O ganho é importante porque o agente não precisa reaprender a mesma conversa inteira a cada chamada.
TensorRT Edge-LLM usa previsão de múltiplos tokens em árvore
Outra otimização foi a previsão de múltiplos tokens, ou MTP. No processo autoregressivo tradicional, o modelo gera um token por vez. Com MTP, um modelo auxiliar sugere possíveis tokens futuros e o modelo principal verifica essas sugestões em conjunto.
O TensorRT Edge-LLM foi além de uma sequência linear: organizou as possibilidades em uma árvore de candidatos. Na configuração usada no benchmark, foram aplicados oito passos de geração preliminar, dois candidatos principais em cada profundidade e uma árvore de verificação com 16 nós.
Essa abordagem combina bem com chamadas de função, nas quais nomes de ferramentas, estruturas JSON e partes dos argumentos tendem a seguir padrões previsíveis. A NVIDIA afirma que a previsão em árvore entregou um ganho adicional de 40% na decodificação em comparação com uma implementação linear de MTP com três passos de previsão.
O resultado mostra por que a velocidade de um agente não depende apenas do modelo escolhido. O tempo também está relacionado à forma como o sistema gerencia o contexto, a memória e as várias tentativas de geração. Para quem acompanha o avanço dos agentes de IA prontos, essa camada de infraestrutura ajuda a explicar o que acontece por trás de uma interface aparentemente simples.
TensorRT Edge-LLM aproxima a IA generativa do dispositivo
O benchmark é relevante porque aponta para um cenário em que agentes de IA executam tarefas diretamente em veículos, robôs e outros dispositivos de borda, sem depender o tempo todo de um data center. Menor latência, disponibilidade local e controle sobre os dados podem ser vantagens importantes nesses ambientes.
Isso não significa que o Jetson AGX Thor substitua automaticamente a infraestrutura em nuvem. Modelos grandes continuam exigindo memória, energia e configuração cuidadosa. Além disso, o resultado divulgado depende de um modelo específico, de uma versão específica do software e de uma carga de trabalho padronizada.
A NVIDIA disponibilizou a implementação usada no benchmark na ramificação release/0.9.1-mlpinf do TensorRT Edge-LLM, junto com configurações de exportação, comandos para construir os mecanismos TensorRT e parâmetros do servidor compatível com a API da OpenAI. Isso permite que desenvolvedores reproduzam o processo, desde que tenham o hardware e o ambiente necessários.
O que o resultado do TensorRT Edge-LLM realmente mostra
O principal avanço não está apenas no número de 6,4 vezes mais rápido. O resultado mostra que a execução de agentes de IA exige otimizações diferentes das usadas em um chatbot que responde a uma única pergunta. Quando o histórico cresce, reutilizar o que já foi calculado pode ser tão importante quanto acelerar a geração de novos tokens.
Assim, o TensorRT Edge-LLM combina três ideias: representar o modelo de forma mais compacta, evitar o processamento repetido do contexto e prever vários tokens antes da verificação final. O benchmark do MLPerf sugere que essa combinação pode tornar cargas agentivas longas mais viáveis em dispositivos de borda.
A questão deixada no início também fica mais clara: a velocidade não veio de um único truque, mas da coordenação entre hardware, runtime, quantização e gerenciamento de contexto. Para a IA sair do data center e atuar no mundo físico, esse tipo de eficiência será tão importante quanto a capacidade de raciocinar do próprio modelo.