Generic selectors
Exact matches only
Search in title
Search in content
Post Type Selectors

Hugging Face apresenta tokenizers v1 com até 30 vezes mais velocidade

Hugging Face apresenta tokenizers v1 com até 30 vezes mais velocidade
A Hugging Face apresentou o release candidate do tokenizers v1, que promete codificar textos até 30 vezes mais rápido que a versão 0.23 sem alterar os IDs produzidos.

Índice

Tempo de leitura: 5 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. A Hugging Face apresentou o release candidate do tokenizers v1, uma nova versão da biblioteca responsável por transformar textos em tokens para modelos de inteligência artificial. A promessa é ambiciosa: acelerar a codificação de textos em até 30 vezes em comparação com a versão 0.23, sem alterar os IDs produzidos pelos tokenizadores.

O resultado chama atenção porque a tokenização costuma parecer uma etapa pequena diante do processamento de um modelo. Mas, em sistemas que recebem muitos pedidos, trabalham com contextos longos ou precisam responder rapidamente ao primeiro token, alguns microssegundos podem se transformar em uma fila inteira de solicitações. É justamente nesse ponto que o tokenizers v1 tenta fazer diferença.

O que muda no tokenizers v1

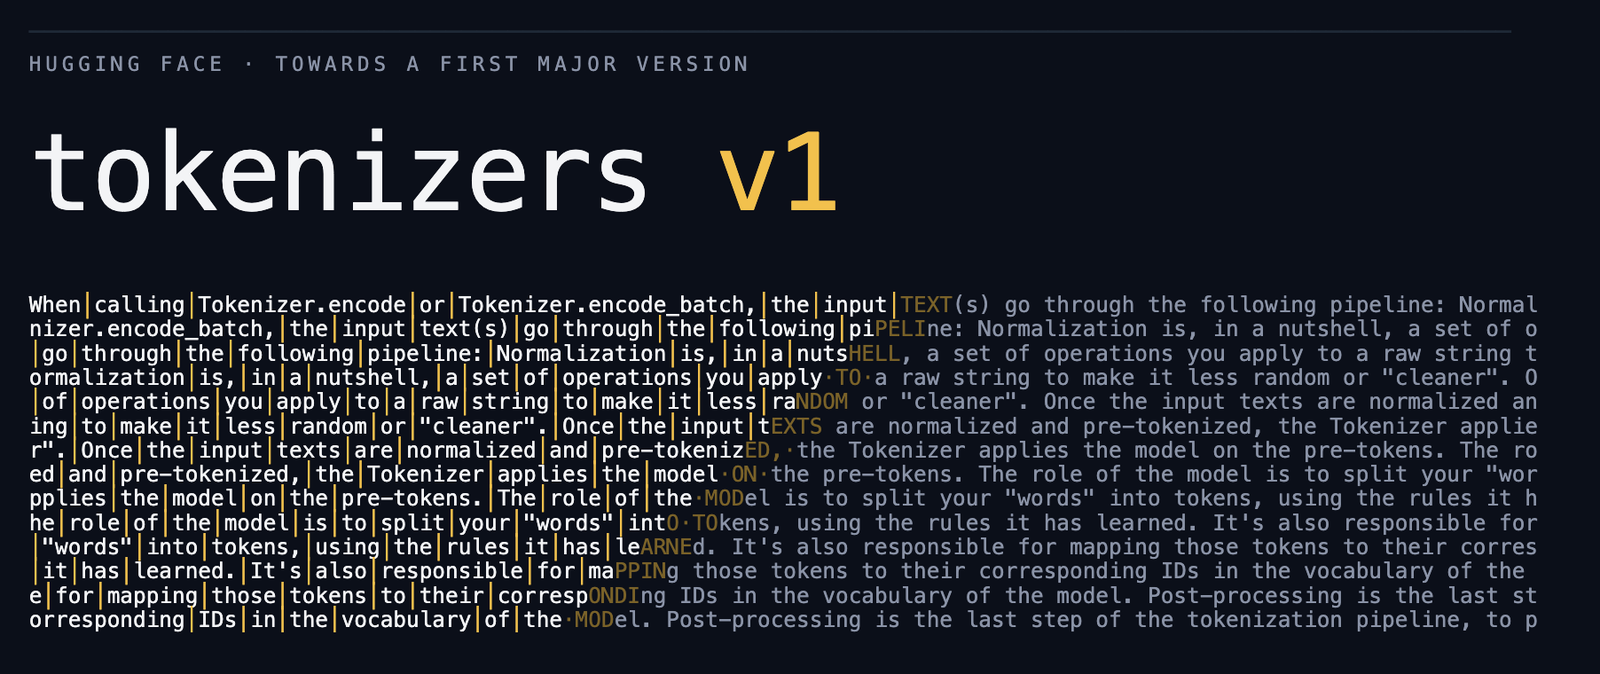
Um tokenizador converte texto em uma sequência de números que o modelo consegue interpretar. Esse processo passa por quatro etapas principais: normalização, pré-tokenização, aplicação do modelo e pós-processamento. A Hugging Face afirma que o tokenizers v1 preserva os mesmos IDs, a mesma API, o vocabulário e as posições de mesclagem da versão 0.23.

Na prática, a biblioteca busca melhorar o caminho interno sem mudar o resultado. O suporte continua abrangendo famílias como BPE, WordPiece e Unigram, em vez de se concentrar exclusivamente em BPE. A maior parte dos ganhos medidos, porém, aparece nos tokenizadores baseados em BPE.

Tokenizers v1 alcança até 30 vezes mais desempenho

Nos testes divulgados pela Hugging Face, o caminho de codificação do tokenizers v1 ficou entre 3 e 30 vezes mais rápido que o tokenizers 0.23 em execução com uma única thread, usando um Apple M4 Max. O menor ganho foi observado no modelo T5-base, enquanto o maior apareceu no GPT-2.

O desempenho também melhorou em cenários multilíngues. Na comparação com a versão anterior, os testes registraram ganhos de 14,6 vezes em amárico, 12,5 vezes em hindi, 11,9 vezes em bengali, 11,3 vezes em árabe, 9,3 vezes em coreano, 7,1 vezes em japonês e 6,8 vezes em chinês.

Com oito trabalhadores, a biblioteca alcançou 76% da escalabilidade linear, segundo os benchmarks. A latência p99 para documentos em inglês de 512 bytes caiu de 110 microssegundos no tokenizers 0.23 para 7 microssegundos no tokenizers v1. A comparação foi realizada chamada a chamada e teve como referência o mesmo equipamento.

Como o tokenizers v1 reduz o trabalho da CPU

Os ganhos não vêm de uma única mudança. A nova versão reorganiza diferentes pontos do pipeline para evitar alocações, reduzir cópias e aproveitar melhor o paralelismo disponível no processador.

Divisão com bitstreams em vez de regex

Nos tokenizadores BPE, o texto é dividido em partes menores antes da etapa de mesclagem. A versão anterior dependia de um mecanismo geral de expressões regulares para realizar essa divisão. No tokenizers v1, padrões compatíveis podem usar o Bitcannon, uma implementação baseada em operações booleanas sobre fluxos de bits e instruções SIMD.

A proposta é analisar vários bytes de uma vez, em vez de avançar caractere por caractere. O material da Hugging Face informa que o Bitcannon consegue decidir sobre 64 bytes por operação de registrador em determinados padrões. A otimização, no entanto, não se aplica a todos os tokenizadores: aqueles cujo padrão não é reconhecido continuam usando o caminho de regex.

Cache para palavras repetidas

Textos reais repetem palavras, símbolos e trechos com frequência. Como um mesmo pré-token produz sempre os mesmos IDs, o tokenizers v1 pode guardar o resultado em um cache local da thread. Quando a mesma sequência aparece novamente, a biblioteca evita executar todo o processo de mesclagem.

O benefício depende do conteúdo analisado. Em testes com prefixos compartilhados, a configuração com cache chegou a apresentar 2,03 vezes mais throughput. Já em textos com poucas repetições, o custo de consultar o cache pode não ser compensado por acertos suficientes. Não existe um botão mágico que acelere qualquer entrada; há apenas uma otimização que funciona melhor quando o texto oferece oportunidades para reutilização.

Loop de mesclagem com menos alocações

O loop de mesclagem do BPE precisa encontrar pares adjacentes e combiná-los de acordo com sua prioridade. A nova implementação usa um buffer temporário fornecido pelo chamador, evitando alocações repetidas durante cada chamada.

Os símbolos ficam em uma estrutura plana e são conectados por posições, o que permite atualizar índices sem mover blocos inteiros de dados. Além disso, vários pré-tokens podem ser processados em uma única chamada do modelo. O resultado é um caminho mais próximo de uma linha de montagem eficiente do que de uma sequência de pequenos trabalhos isolados.

O impacto do tokenizers v1 em aplicações de IA

A tokenização acontece antes da inferência. Isso significa que nenhum modelo pode devolver o primeiro token de uma resposta antes que o prompt seja convertido para a representação numérica esperada. Em aplicações com agentes, contextos extensos e prefixos reutilizados, esse atraso pode aparecer diretamente no tempo até o primeiro token.

Imagine um sistema que recebe centenas de solicitações simultâneas para analisar documentos. O modelo pode estar executando rapidamente na GPU, mas a CPU ainda precisa preparar cada entrada. Se a tokenização não acompanhar o ritmo, o acelerador fica esperando, como uma cozinha moderna parada porque os ingredientes ainda não chegaram à bancada.

Por isso, os ganhos do tokenizers v1 são especialmente relevantes para servidores de inferência, treinamento em grandes conjuntos de dados e aplicações que processam muitos textos curtos ou documentos longos em sequência. A melhoria não torna o modelo em si mais inteligente, mas pode reduzir o tempo desperdiçado antes que ele comece a trabalhar.

O que ainda falta antes da versão 1.0.0

O material publicado descreve o tokenizers v1 como um release candidate, e não como uma versão final. A biblioteca ainda deve receber suporte ampliado a outras famílias de modelos, melhorias no decoding, bindings para Node.js e avanços nas integrações com Python, ExecuTorch e llama.cpp.

Também estão planejadas mudanças como uma implementação única de codificação para evitar divergências entre treinamento e inferência, offsets e máscaras opcionais, revisões nos normalizadores e suporte experimental a processamento em dispositivos aceleradores. A Hugging Face menciona ainda a possibilidade de explorar codificação em GPU e decodificação em lote, mas trata esse trabalho como uma etapa sujeita a prototipagem e medição.

Como os números foram publicados em 21 de setembro de 2026 e ainda se referem a um release candidate, o conteúdo deve ser revisado antes da publicação definitiva para confirmar a evolução da versão e a disponibilidade dos pacotes.

Por que essa atualização importa

O ponto mais importante do tokenizers v1 é que a velocidade foi aumentada sem mudar os IDs gerados. Para quem já utiliza a biblioteca, isso reduz o risco de uma troca que altere a forma como os modelos interpretam os textos de entrada.

Os benchmarks também mostram por que medir uma biblioteca de tokenização exige cuidado. O resultado pode variar conforme o modelo, o idioma, a quantidade de threads, o uso de cache e o tipo de entrada. A Hugging Face usou loops de medição comuns, verificou hashes dos IDs produzidos, separou o carregamento do vocabulário e fixou os trabalhadores em núcleos físicos para tornar as comparações mais consistentes.

No fim, o tokenizers v1 não representa apenas uma tentativa de produzir números maiores em um gráfico. Ele mostra que uma etapa considerada secundária pode se tornar um gargalo quando os modelos ficam mais rápidos e os sistemas passam a processar mais solicitações. A promessa da nova versão é simples: entregar exatamente a mesma tokenização, mas com menos trabalho desperdiçado no caminho.
Fontes

RECENTES

NVIDIA apresenta green contexts no CUDA 13.1 para controlar como a GPU compartilha recursos
A NVIDIA apresenta os green contexts no CUDA 13.1, recurso que permite dividir SMs e workqueues da GPU para reduzir interferências entre cargas concorrentes e melhorar a previsibilidade da latência.
NVIDIA lança AICR v1.0 para configurar clusters de GPUs de forma aberta e verificável
A NVIDIA lançou o AICR v1.0, projeto aberto que organiza receitas versionadas, gera artefatos de implantação e valida configurações de clusters de GPUs para Kubernetes.

LEIS MAIS


CONTINUE NO PLANKSNET

Ajuste fino do Nemotron alcança resultados de nível ouro na IOI e na IMO
7 min de leitura
A NVIDIA afirma que o ajuste fino do Nemotron levou modelos especializados a resultados de nível ouro na IOI 2026 e na IMO 2026, combinando treinamento, aprendizado por reforço e revisão iterativa.
Liquid AI lança modelos d1 multimodais para decisões na borda
5 min de leitura
A Liquid AI lançou o d1-3B e o experimental d1-omni-600M, modelos abertos e multimodais criados para decisões rápidas em dispositivos de borda.

VEJA TAMBÉM

Hugging Face apresenta tokenizers v1 com até 30 vezes mais velocidade

Hugging Face apresenta tokenizers v1 com até 30 vezes mais velocidade
A Hugging Face apresentou o release candidate do tokenizers v1, que promete codificar textos até 30 vezes mais rápido que a versão 0.23 sem alterar os IDs produzidos.

Índice

Tempo de leitura: 5 minutos

Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. A Hugging Face apresentou o release candidate do tokenizers v1, uma nova versão da biblioteca responsável por transformar textos em tokens para modelos de inteligência artificial. A promessa é ambiciosa: acelerar a codificação de textos em até 30 vezes em comparação com a versão 0.23, sem alterar os IDs produzidos pelos tokenizadores.

O resultado chama atenção porque a tokenização costuma parecer uma etapa pequena diante do processamento de um modelo. Mas, em sistemas que recebem muitos pedidos, trabalham com contextos longos ou precisam responder rapidamente ao primeiro token, alguns microssegundos podem se transformar em uma fila inteira de solicitações. É justamente nesse ponto que o tokenizers v1 tenta fazer diferença.

O que muda no tokenizers v1

Um tokenizador converte texto em uma sequência de números que o modelo consegue interpretar. Esse processo passa por quatro etapas principais: normalização, pré-tokenização, aplicação do modelo e pós-processamento. A Hugging Face afirma que o tokenizers v1 preserva os mesmos IDs, a mesma API, o vocabulário e as posições de mesclagem da versão 0.23.

Na prática, a biblioteca busca melhorar o caminho interno sem mudar o resultado. O suporte continua abrangendo famílias como BPE, WordPiece e Unigram, em vez de se concentrar exclusivamente em BPE. A maior parte dos ganhos medidos, porém, aparece nos tokenizadores baseados em BPE.

Tokenizers v1 alcança até 30 vezes mais desempenho

Nos testes divulgados pela Hugging Face, o caminho de codificação do tokenizers v1 ficou entre 3 e 30 vezes mais rápido que o tokenizers 0.23 em execução com uma única thread, usando um Apple M4 Max. O menor ganho foi observado no modelo T5-base, enquanto o maior apareceu no GPT-2.

O desempenho também melhorou em cenários multilíngues. Na comparação com a versão anterior, os testes registraram ganhos de 14,6 vezes em amárico, 12,5 vezes em hindi, 11,9 vezes em bengali, 11,3 vezes em árabe, 9,3 vezes em coreano, 7,1 vezes em japonês e 6,8 vezes em chinês.

Com oito trabalhadores, a biblioteca alcançou 76% da escalabilidade linear, segundo os benchmarks. A latência p99 para documentos em inglês de 512 bytes caiu de 110 microssegundos no tokenizers 0.23 para 7 microssegundos no tokenizers v1. A comparação foi realizada chamada a chamada e teve como referência o mesmo equipamento.

Como o tokenizers v1 reduz o trabalho da CPU

Os ganhos não vêm de uma única mudança. A nova versão reorganiza diferentes pontos do pipeline para evitar alocações, reduzir cópias e aproveitar melhor o paralelismo disponível no processador.

Divisão com bitstreams em vez de regex

Nos tokenizadores BPE, o texto é dividido em partes menores antes da etapa de mesclagem. A versão anterior dependia de um mecanismo geral de expressões regulares para realizar essa divisão. No tokenizers v1, padrões compatíveis podem usar o Bitcannon, uma implementação baseada em operações booleanas sobre fluxos de bits e instruções SIMD.

A proposta é analisar vários bytes de uma vez, em vez de avançar caractere por caractere. O material da Hugging Face informa que o Bitcannon consegue decidir sobre 64 bytes por operação de registrador em determinados padrões. A otimização, no entanto, não se aplica a todos os tokenizadores: aqueles cujo padrão não é reconhecido continuam usando o caminho de regex.

Cache para palavras repetidas

Textos reais repetem palavras, símbolos e trechos com frequência. Como um mesmo pré-token produz sempre os mesmos IDs, o tokenizers v1 pode guardar o resultado em um cache local da thread. Quando a mesma sequência aparece novamente, a biblioteca evita executar todo o processo de mesclagem.

O benefício depende do conteúdo analisado. Em testes com prefixos compartilhados, a configuração com cache chegou a apresentar 2,03 vezes mais throughput. Já em textos com poucas repetições, o custo de consultar o cache pode não ser compensado por acertos suficientes. Não existe um botão mágico que acelere qualquer entrada; há apenas uma otimização que funciona melhor quando o texto oferece oportunidades para reutilização.

Loop de mesclagem com menos alocações

O loop de mesclagem do BPE precisa encontrar pares adjacentes e combiná-los de acordo com sua prioridade. A nova implementação usa um buffer temporário fornecido pelo chamador, evitando alocações repetidas durante cada chamada.

Os símbolos ficam em uma estrutura plana e são conectados por posições, o que permite atualizar índices sem mover blocos inteiros de dados. Além disso, vários pré-tokens podem ser processados em uma única chamada do modelo. O resultado é um caminho mais próximo de uma linha de montagem eficiente do que de uma sequência de pequenos trabalhos isolados.

O impacto do tokenizers v1 em aplicações de IA

A tokenização acontece antes da inferência. Isso significa que nenhum modelo pode devolver o primeiro token de uma resposta antes que o prompt seja convertido para a representação numérica esperada. Em aplicações com agentes, contextos extensos e prefixos reutilizados, esse atraso pode aparecer diretamente no tempo até o primeiro token.

Imagine um sistema que recebe centenas de solicitações simultâneas para analisar documentos. O modelo pode estar executando rapidamente na GPU, mas a CPU ainda precisa preparar cada entrada. Se a tokenização não acompanhar o ritmo, o acelerador fica esperando, como uma cozinha moderna parada porque os ingredientes ainda não chegaram à bancada.

Por isso, os ganhos do tokenizers v1 são especialmente relevantes para servidores de inferência, treinamento em grandes conjuntos de dados e aplicações que processam muitos textos curtos ou documentos longos em sequência. A melhoria não torna o modelo em si mais inteligente, mas pode reduzir o tempo desperdiçado antes que ele comece a trabalhar.

O que ainda falta antes da versão 1.0.0

O material publicado descreve o tokenizers v1 como um release candidate, e não como uma versão final. A biblioteca ainda deve receber suporte ampliado a outras famílias de modelos, melhorias no decoding, bindings para Node.js e avanços nas integrações com Python, ExecuTorch e llama.cpp.

Também estão planejadas mudanças como uma implementação única de codificação para evitar divergências entre treinamento e inferência, offsets e máscaras opcionais, revisões nos normalizadores e suporte experimental a processamento em dispositivos aceleradores. A Hugging Face menciona ainda a possibilidade de explorar codificação em GPU e decodificação em lote, mas trata esse trabalho como uma etapa sujeita a prototipagem e medição.

Como os números foram publicados em 21 de setembro de 2026 e ainda se referem a um release candidate, o conteúdo deve ser revisado antes da publicação definitiva para confirmar a evolução da versão e a disponibilidade dos pacotes.

Por que essa atualização importa

O ponto mais importante do tokenizers v1 é que a velocidade foi aumentada sem mudar os IDs gerados. Para quem já utiliza a biblioteca, isso reduz o risco de uma troca que altere a forma como os modelos interpretam os textos de entrada.

Os benchmarks também mostram por que medir uma biblioteca de tokenização exige cuidado. O resultado pode variar conforme o modelo, o idioma, a quantidade de threads, o uso de cache e o tipo de entrada. A Hugging Face usou loops de medição comuns, verificou hashes dos IDs produzidos, separou o carregamento do vocabulário e fixou os trabalhadores em núcleos físicos para tornar as comparações mais consistentes.

No fim, o tokenizers v1 não representa apenas uma tentativa de produzir números maiores em um gráfico. Ele mostra que uma etapa considerada secundária pode se tornar um gargalo quando os modelos ficam mais rápidos e os sistemas passam a processar mais solicitações. A promessa da nova versão é simples: entregar exatamente a mesma tokenização, mas com menos trabalho desperdiçado no caminho.
Fontes

Hugging Face apresenta tokenizers v1 com até 30 vezes mais velocidade

VEJA TAMBÉM