Tempo de leitura: 5 minutos
Olá, é um prazer inenarrável estar mais uma vez escrevendo este post. Em 23 de setembro de 2026, a NVIDIA apresentou oficialmente o NodeWright no Kubernetes, um projeto de código aberto criado para configurar e atualizar sistemas operacionais de nós em clusters sem interromper desnecessariamente as cargas de trabalho. A proposta parece simples, mas resolve um problema que costuma aparecer justamente quando a infraestrutura cresce: como aplicar uma mudança em centenas de máquinas sem transformar a manutenção em uma operação manual e arriscada?
Em clusters com GPUs, a dificuldade é ainda maior. Um nó pode estar executando um treinamento longo, depender de configurações específicas de rede ou exigir ajustes no kernel. Por isso, trocar ou reiniciar máquinas como se fossem servidores comuns nem sempre é uma opção. O NodeWright no Kubernetes tenta levar a mesma lógica declarativa usada para gerenciar workloads para a camada do sistema operacional.
Por que o NodeWright no Kubernetes foi criado
Ferramentas como Ansible e Puppet continuam úteis para configurar servidores individualmente. O problema surge quando a máquina faz parte de um cluster ativo, com pods críticos, políticas de interrupção e cargas que não podem simplesmente ser deslocadas. Um script tradicional pode alterar um parâmetro corretamente e, ainda assim, causar uma interrupção no momento errado.
O NodeWright no Kubernetes foi projetado para entender esse contexto. Segundo a NVIDIA, o projeto pode lidar com operações como ajuste de parâmetros do kernel, instalação de pacotes, correções relacionadas a vulnerabilidades, agentes de segurança e configuração de mecanismos de coleta de falhas. A diferença está em tratar essas mudanças como operações coordenadas dentro do cluster, e não como comandos isolados em uma lista de servidores.
Na prática, a ferramenta funciona como uma espécie de gerenciador de pacotes para toda a frota. Porém, em vez de apenas instalar um pacote e seguir adiante, ela considera o estado dos workloads antes de modificar o nó. É essa camada de coordenação que separa uma atualização automatizada de um simples script executado em massa.
Como o NodeWright no Kubernetes aplica mudanças nos nós
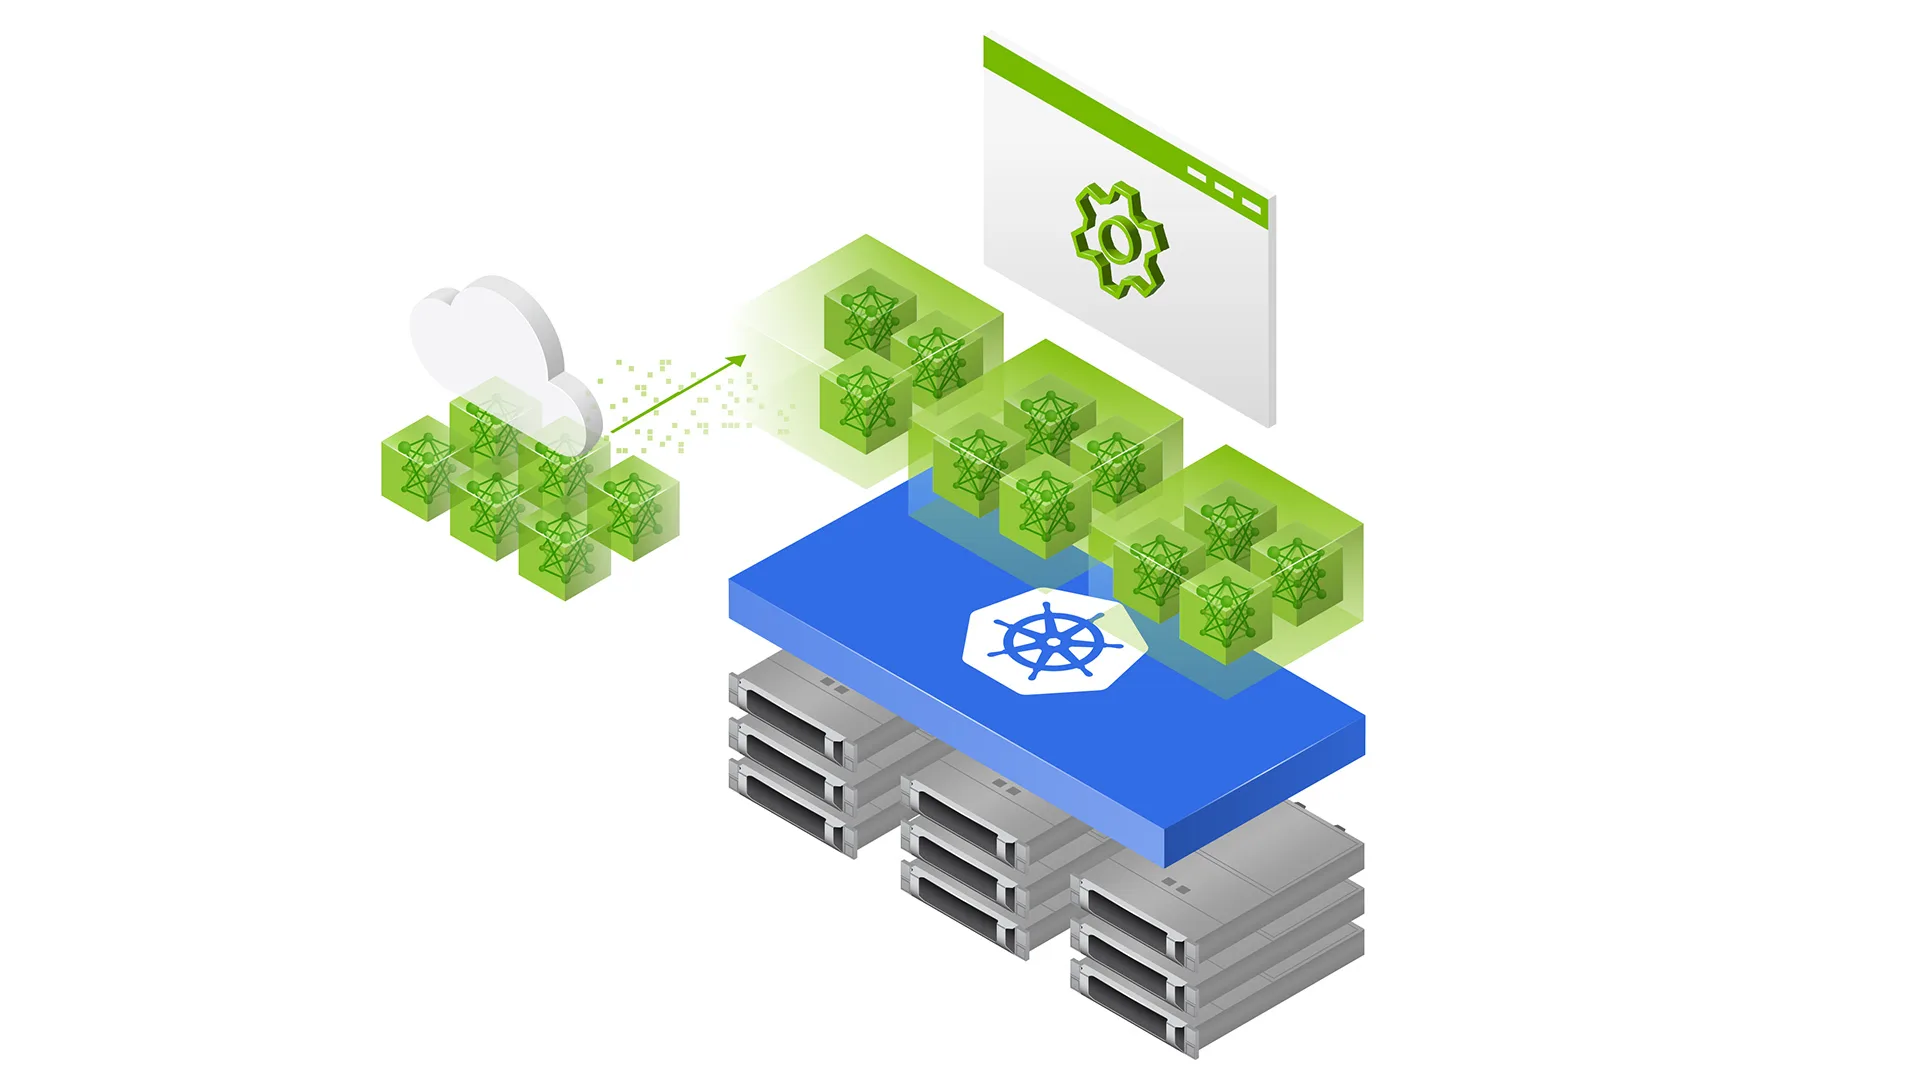
O projeto é formado por um operador Kubernetes, recursos personalizados e pacotes. O operador observa esses recursos e controla o ciclo de vida das alterações. Já os pacotes são imagens de contêiner que carregam scripts, configurações e binários necessários para realizar a modificação no sistema operacional.
O fluxo pode incluir o bloqueio de novos agendamentos no nó, a espera por pods críticos, o esvaziamento controlado das cargas, a aplicação dos pacotes e a liberação do nó novamente. A operação também considera elementos do Kubernetes como PodDisruptionBudgets, seletores de nós, taints e tolerations. Se uma verificação falhar, o pacote pode sinalizar o problema ao próprio Kubernetes e interromper a progressão da atualização.
Essa abordagem é importante porque uma mudança de infraestrutura raramente falha de maneira conveniente. Um parâmetro incorreto pode impedir a inicialização de um serviço; uma atualização de kernel pode afetar uma pilha de rede; e uma configuração incompleta pode só ser percebida quando o próximo workload for executado. As verificações incluídas nos pacotes ajudam a tornar esse tipo de falha visível durante o processo.
Políticas de implantação do NodeWright no Kubernetes
Para evitar que uma alteração seja aplicada a toda a frota de uma vez, o NodeWright no Kubernetes permite definir políticas de implantação progressiva. Os nós podem ser selecionados por rótulos, e as mudanças podem avançar em lotes com estratégias fixas, lineares ou exponenciais.
Também é possível configurar limites de sucesso e falha. Assim, uma equipe pode começar com uma parte do pool de GPUs, observar os resultados e só então ampliar a operação. É uma lógica parecida com testar uma ponte antes de liberar uma caravana inteira para atravessá-la: o objetivo não é eliminar todo risco, mas impedir que um erro localizado se transforme em uma indisponibilidade generalizada.
Como os recursos são definidos de forma declarativa, o gerenciamento pode ser integrado a ferramentas já usadas em fluxos Kubernetes, como Helm, kubectl e plataformas de GitOps. Isso permite que a configuração desejada dos nós seja registrada, revisada e reaplicada de maneira consistente.
NodeWright no Kubernetes dentro do ecossistema DSX
A NVIDIA posiciona o NodeWright no Kubernetes como parte do DSX OS, uma camada de software de código aberto voltada à operação de infraestrutura acelerada. Nesse ecossistema, o projeto trabalha ao lado de componentes como o GPU Operator, o Network Operator, o NVIDIA Cluster Readiness Engine e o NVSentinel.
A proposta não é obrigar as equipes a adotar uma plataforma monolítica. O NodeWright pode ser usado isoladamente ou combinado com outros projetos, dependendo das necessidades do ambiente. A NVIDIA também relaciona o projeto ao NVIDIA AI Cluster Runtime, que usa receitas com versões controladas para validar e aplicar configurações de host associadas a cargas de IA.
O lançamento também se encaixa em uma tendência mais ampla de tornar a infraestrutura de IA consciente da topologia, da disponibilidade dos recursos e das condições operacionais dos nós. Um exemplo relacionado é o Topograph para clusters de IA, apresentado pela NVIDIA para ajudar no posicionamento de cargas considerando a topologia do ambiente.
O que o NodeWright no Kubernetes muda para as equipes
O principal ganho do NodeWright no Kubernetes não está apenas em automatizar a instalação de pacotes. A mudança mais significativa é transformar a manutenção dos hosts em um objeto observável e declarativo do próprio cluster. Em vez de depender de uma planilha para saber quais máquinas foram atualizadas, a equipe pode acompanhar o estado da operação por meio dos recursos Kubernetes.
Isso não elimina a necessidade de revisão humana. Atualizações de kernel, mudanças de rede e correções de segurança continuam exigindo testes, compatibilidade com o hardware e uma estratégia de recuperação. A automação reduz o trabalho repetitivo e organiza a execução, mas não substitui a validação de que um pacote é adequado para determinada combinação de GPU, sistema operacional e ambiente de nuvem.
O NodeWright foi usado internamente pela NVIDIA sob o nome Skyhook e agora está disponível como projeto de código aberto sob a licença Apache 2.0. A empresa também abriu um repositório de pacotes para receber contribuições voltadas a diferentes combinações de hardware, provedores de nuvem e perfis de configuração.
Conclusão: o que esperar do NodeWright no Kubernetes
O lançamento do NodeWright no Kubernetes representa uma tentativa de levar a gestão declarativa além dos contêineres e workloads, alcançando também os sistemas operacionais que sustentam os nós. Isso é especialmente relevante em clusters com GPUs, nos quais substituir uma máquina ou interromper um treinamento pode custar tempo e recursos significativos.
A resposta para a pergunta do início é que uma mudança em larga escala não precisa depender apenas de uma janela de manutenção e de alguém acompanhando um terminal durante a madrugada. Com políticas graduais, verificações, respeito às regras do Kubernetes e acompanhamento do estado da operação, a atualização pode ser tratada como parte do ciclo normal de gestão do cluster.
O projeto ainda exige avaliação cuidadosa antes de ser usado em produção, principalmente por estar ligado a componentes sensíveis do sistema operacional. Mas a direção é clara: o NodeWright no Kubernetes tenta transformar a manutenção de frotas de nós em uma operação reproduzível, auditável e menos dependente de procedimentos manuais.